
Votre propre voix
Votre propre voix
Quand InterMIND traduit votre parole pour un autre participant, il n'entend pas un narrateur robotique de synthèse vocale. Il entend une voix clairement reconnaissable comme la vôtre — qui conserve votre timbre et votre façon de parler — et qui prononce désormais les mots dans sa langue.
Cela fonctionne dans les deux sens et pour chaque participant de façon indépendante. Dans une réunion où cinq personnes parlent cinq langues, chacun entend les quatre autres dans sa propre langue, et chacun de ces quatre conserve sa voix.
À quoi cela ressemble
La plupart des outils de traduction en direct remplacent le locuteur par une seule voix synthétique générique. Le résultat est intelligible mais plat — on perd qui parle, l'intonation, la personnalité. InterMIND conserve la voix du locuteur, de sorte qu'une réunion traduite ressemble à une conversation entre les personnes qui y participent réellement, et non à une file d'annonces lues par une machine.
Comment cela fonctionne
InterMIND utilise un pipeline en cascade, et l'étape vocale est la dernière :
- Reconnaissance vocale — vos paroles sont transcrites dans votre propre langue, à mesure que vous parlez.
- Segmentation — la transcription est regroupée en fragments de phrase stables (propositions) afin que la traduction puisse commencer avant que vous ayez fini la phrase.
- Traduction — chaque fragment est traduit progressivement dans la langue de l'interlocuteur.
- Synthèse vocale — chaque fragment traduit est prononcé à l'aide d'un échantillon de votre propre voix, puis envoyé à l'interlocuteur.
Tant que la réunion rassemble encore suffisamment de votre parole pour modéliser votre voix (environ les 5 à 10 premières secondes), la synthèse utilise le fragment audio qui correspond à ce que vous venez de dire dans votre langue source. Une fois l'échantillon assez long, elle passe à l'utilisation de cet échantillon pour tout ce qui suit. En pratique, on ne perçoit aucune transition — la traduction ressemble de plus en plus à vous au fur et à mesure de l'appel. Ce ne sera pas une imitation parfaite de votre voix, mais c'est reconnaissable comme étant vous plutôt qu'un narrateur générique — et la ressemblance ne cesse de s'améliorer à mesure que le modèle vous entend.
Langues
La traduction votre-propre-voix est disponible pour les 23 langues vocales — l'ensemble figurant dans Choisir les langues. Rien à activer séparément : lorsque la traduction est activée, les participants vous entendent automatiquement dans votre propre voix.
Votre échantillon vocal enregistré (facultatif)
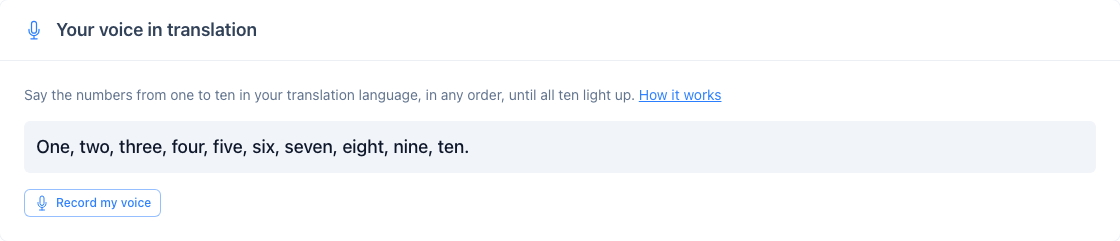
Les utilisateurs connectés peuvent ignorer la phase d'échauffement en enregistrant un échantillon vocal une fois dans Paramètres → Your voice in translation : appuyez sur Enregistrer ma voix, dites les chiffres de un à dix dans n'importe quel ordre, et l'échantillon s'enregistre quand les dix sont allumés. À partir de votre prochaine réunion, votre parole traduite est vocalisée avec cet échantillon dès la première phrase.
Confidentialité
Deux échantillons, deux durées de vie. L'échantillon en direct utilisé pour l'échauffement pendant la réunion est éphémère : il n'existe que pendant la durée de la réunion en direct et n'est stocké nulle part ; l'API et le SDK Mind qui alimentent la session en temps réel ne conservent aucune donnée une fois la conférence terminée. L'échantillon enregistré depuis les Paramètres est conservé avec votre compte à une seule fin, vocaliser votre parole traduite, est envoyé au moteur de traduction à chaque fois que vous rejoignez une réunion, et est supprimé dès que vous le retirez ou que vous supprimez votre compte. Aucun des deux ne fait partie des fonctions d'enregistrement vidéo et audio d'InterMIND, des enregistrements distincts et explicites que vous lancez volontairement.
Dans la feuille de route : synchronisation labiale
Entendre la traduction dans votre propre voix est la première moitié d'un objectif plus large. La prochaine étape sur laquelle nous travaillons est la synchronisation labiale — recaler les lèvres du locuteur à la caméra pour qu'elles correspondent à l'audio traduit, de sorte que chaque participant semble parler la langue de l'autre. Combinée à la traduction votre-propre-voix, l'ambition est un appel où des personnes qui n'ont aucune langue en commun se voient et s'entendent comme si chacune parlait la langue de l'autre de façon native.
Il s'agit d'un élément de la feuille de route, pas encore d'une fonctionnalité livrée — la traduction votre-propre-voix ci-dessus est disponible aujourd'hui.