
La tua voce
La tua stessa voce
Quando InterMIND traduce il tuo discorso per un altro partecipante, non sentono un narratore robotico text-to-speech. Sentono una voce riconoscibilmente tua — che porta il tuo timbro e il tuo modo di parlare — che ora pronuncia le parole nella loro lingua.
Funziona in entrambe le direzioni e per ogni partecipante in modo indipendente. In una riunione in cui cinque persone parlano cinque lingue, ciascuno sente gli altri quattro nella propria lingua, e ciascuno di quei quattro suona ancora come se stesso.
Come suona
La maggior parte degli strumenti di traduzione in diretta sostituisce l'oratore con un'unica voce sintetica generica. Il risultato è comprensibile ma piatto — si perde chi sta parlando, l'enfasi, la personalità. InterMIND conserva la voce di chi parla, quindi una riunione tradotta sembra una conversazione tra le persone che vi partecipano realmente, non una coda di annunci letti da una macchina.
Come funziona
InterMIND utilizza una pipeline a cascata, e il passaggio della voce è l'ultima fase:
- Riconoscimento vocale — le tue parole vengono trascritte nella tua lingua, mentre parli.
- Segmentazione — la trascrizione viene raggruppata in frammenti di frase stabili (proposizioni) in modo che la traduzione possa iniziare prima che tu finisca la frase.
- Traduzione — ogni frammento viene tradotto progressivamente nella lingua dell'ascoltatore.
- Sintesi vocale — ogni frammento tradotto viene riprodotto utilizzando un campione della tua stessa voce, e inviato all'ascoltatore.
Mentre la riunione sta ancora raccogliendo abbastanza del tuo parlato per modellare la tua voce (circa i primi 5–10 secondi), la sintesi utilizza il frammento audio che corrisponde a ciò che hai appena detto nella tua lingua di origine. Una volta che c'è un campione abbastanza lungo, passa all'utilizzo di quel campione per tutto il resto. In pratica non si nota alcun cambio — la traduzione suona sempre più come te mentre la chiamata procede. Non sarà un'imitazione perfetta della tua voce, ma è riconoscibilmente tu piuttosto che un narratore generico — e continua a migliorare man mano che il modello ti ascolta.
Lingue
La traduzione con la tua stessa voce è disponibile per tutte le 23 lingue vocali — lo stesso set elencato in Scegliere le lingue. Non c'è nulla da abilitare separatamente: quando la traduzione è attiva, i partecipanti ti sentono automaticamente con la tua voce.
Il tuo campione vocale salvato (Opzionale)
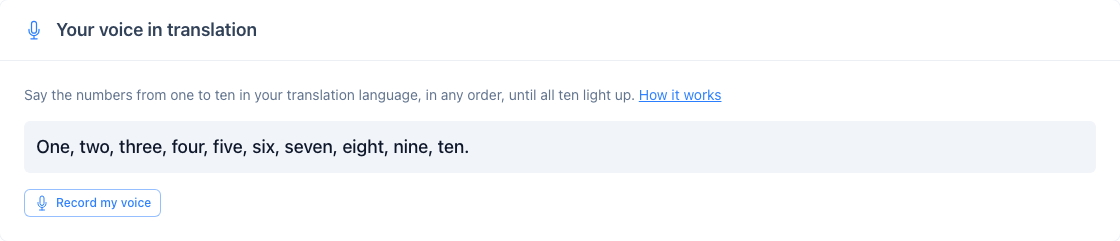
Gli utenti autenticati possono saltare la fase di riscaldamento registrando un campione vocale una sola volta in Impostazioni → La tua voce nella traduzione: premi Registra la mia voce, pronunci i numeri da uno a dieci in qualsiasi ordine e il campione si salverà da solo quando tutti e dieci si illumineranno. Dalla tua prossima riunione, il tuo discorso tradotto verrà pronunciato con essa fin dalla prima frase.
Privacy
Due campioni, due durate. Il campione live utilizzato per il riscaldamento durante la riunione è effimero: esiste solo per la durata della riunione live e non viene archiviato da nessuna parte; le API e l'SDK di Mind che alimentano la sessione in tempo reale non conservano dati una volta terminata la sessione della conferenza. Il campione salvato da Impostazioni è archiviato con il tuo account per un solo scopo, dare voce al tuo discorso tradotto, viene inviato al motore di traduzione ogni volta che ti unisci a una riunione e viene eliminato nel momento in cui lo rimuovi o elimini il tuo account. Nessuno dei due rientra tra le funzionalità di registrazione video e vocale di InterMIND, che sono registrazioni separate ed esplicite che avvii intenzionalmente.
Sulla roadmap: Lip-sync
Sentire la traduzione con la tua stessa voce è la prima metà di un obiettivo più grande. Il prossimo passo verso cui stiamo lavorando è il lip-sync — risequenziare i movimenti della bocca di chi parla sulla videocamera per farla combaciare con l'audio tradotto, in modo che ciascun partecipante sembri parlare la lingua dell'altro. In combinazione con la traduzione con la propria voce, l'obiettivo è una chiamata in cui persone che non condividono alcuna lingua comune si vedono e si sentono come se ciascuno parlasse nativamente la lingua dell'altro.
Questo è un elemento della roadmap, non ancora una funzionalità disponibile — la traduzione con la propria voce descritta sopra è disponibile oggi.