
Su propia voz
Su propia voz
Cuando InterMIND traduce su discurso para otro participante, este no escucha un narrador robótico de texto a voz. Escucha una voz que es inconfundiblemente suya — que conserva su timbre y su forma de hablar — diciendo ahora las palabras en su idioma.
Esto funciona en ambas direcciones y para cada participante de forma independiente. En una reunión donde cinco personas hablan cinco idiomas, cada persona escucha a las otras cuatro en su propio idioma, y cada uno de esos cuatro sigue sonando como ellos mismos.
Cómo suena
La mayoría de las herramientas de traducción en vivo reemplazan al orador con una única voz sintética genérica. El resultado es inteligible pero plano — usted pierde quién está hablando, el énfasis, la personalidad. InterMIND mantiene la voz del orador, por lo que una reunión traducida se siente como una conversación entre las personas que realmente están en ella, no como una cola de anuncios leídos por una máquina.
Cómo funciona
InterMIND utiliza un pipeline en cascada, y el paso de voz es la última etapa:
- Reconocimiento de voz — sus palabras se transcriben en su propio idioma mientras habla.
- Segmentación — la transcripción se agrupa en fragmentos de oración estables (cláusulas) para que la traducción pueda comenzar antes de que termine la oración.
- Traducción — cada fragmento se traduce progresivamente al idioma del oyente.
- Síntesis de voz — cada fragmento traducido se reproduce utilizando una muestra de su propia voz y se envía al oyente.
Mientras la reunión aún recopila lo suficiente de su discurso para modelar su voz (aproximadamente los primeros 5–10 segundos), la síntesis utiliza el fragmento de audio que coincide con lo que acaba de decir en su idioma de origen. Una vez que hay una muestra lo suficientemente larga, cambia a usar esa muestra para todo lo posterior. En la práctica, usted no nota ningún cambio — la traducción suena más como usted a medida que avanza la llamada. No será una imitación impecable de su voz, pero es inconfundiblemente usted en lugar de un narrador genérico — y sigue mejorando a medida que el modelo escucha más de usted.
Idiomas
La traducción con su propia voz está disponible para los 23 idiomas de voz — el mismo conjunto que se indica en Elegir idiomas. No hay nada que activar por separado: cuando la traducción está activada, los participantes le escuchan automáticamente en su propia voz.
Su muestra de voz guardada (Opcional)
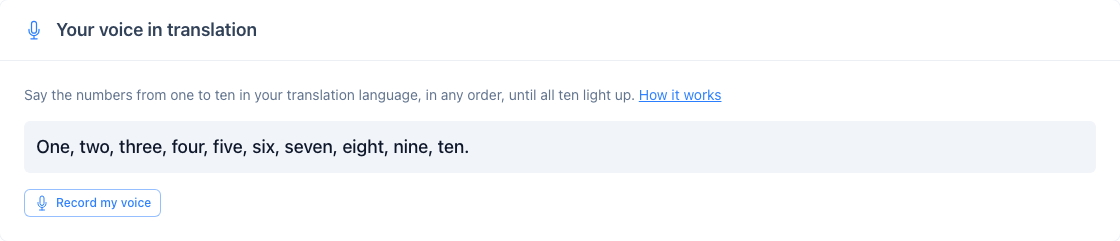
Los usuarios que han iniciado sesión pueden omitir el calentamiento grabando una muestra de voz una vez en Ajustes → Your voice in translation: pulse Grabar mi voz, diga los números del uno al diez en cualquier orden, y la muestra se guarda automáticamente cuando se iluminan los diez. Desde su próxima reunión, su discurso traducido se emitirá con ella desde la primera oración.
Privacidad
Dos muestras, dos ciclos de vida. La muestra en vivo utilizada para el calentamiento durante la reunión es efímera: existe únicamente durante la reunión en vivo y no se almacena en ningún lugar; la API y el SDK de Mind que impulsan la sesión en tiempo real no conservan ningún dato una vez que finaliza la sesión de la conferencia. La muestra guardada de Ajustes se almacena con su cuenta para un único propósito: dar voz a su discurso traducido; se envía al motor de traducción cada vez que se une a una reunión y se elimina en el momento en que la retira o elimina su cuenta. Ninguna forma parte de las funciones de grabación de video y voz de InterMIND, que son grabaciones separadas y explícitas que usted inicia deliberadamente.
En la hoja de ruta: Sincronización labial
Escuchar la traducción con su propia voz es la primera mitad de un objetivo mayor. El siguiente paso en el que estamos trabajando es la sincronización labial — reajustar el movimiento de los labios del orador en la cámara para que coincida con el audio traducido, de modo que cada participante parezca estar hablando el idioma del otro. Combinada con la traducción con la propia voz, la meta es una llamada en la que personas que no comparten un idioma común se vean y se escuchen entre sí como si cada uno hablara el idioma del otro de forma nativa.
Esto es un elemento de la hoja de ruta, no una función lanzada todavía — la traducción con la propia voz mencionada anteriormente está disponible hoy.