
Ihre eigene Stimme
Ihre eigene Stimme
Wenn InterMIND Ihre Sprache für einen anderen Teilnehmer übersetzt, hören diese keinen roboterhaften Text-to-Speech-Sprecher. Sie hören eine Stimme, die unverkennbar Ihre ist — mit Ihrem Klang und Ihrer Art zu sprechen —, die nun die Wörter in ihrer Sprache sagt.
Dies funktioniert in beide Richtungen und für jeden Teilnehmer unabhängig voneinander. In einem Meeting, in dem fünf Personen fünf Sprachen sprechen, hört jede Person die anderen vier in ihrer eigenen Sprache, und jede dieser vier Personen klingt weiterhin wie sie selbst.
Wie es klingt
Die meisten Tools für die Live-Übersetzung ersetzen den Sprecher durch eine einzige generische synthetische Stimme. Das Ergebnis ist verständlich, aber flach — man verliert, wer spricht, die Betonung, die Persönlichkeit. InterMIND behält die Stimme des Sprechers bei, sodass ein übersetztes Meeting wie eine Unterhaltung zwischen den Personen wirkt, die tatsächlich daran teilnehmen, und nicht wie eine Ansage-Liste, die von einer Maschine vorgelesen wird.
Wie es funktioniert
InterMIND verwendet eine kaskadierte Pipeline, und der Stimmen-Schritt ist die letzte Stufe:
- Spracherkennung — Ihre Wörter werden in Ihrer eigenen Sprache transkribiert, während Sie sprechen.
- Segmentierung — Das Transkript wird in stabile Satzfragmente (Teilsätze) gruppiert, damit die Übersetzung beginnen kann, bevor Sie den Satz beendet haben.
- Übersetzung — Jedes Fragment wird schrittweise in die Sprache des Zuhörers übersetzt.
- Stimmsynthese — Jedes übersetzte Fragment wird mit einem Sample Ihrer eigenen Stimme gesprochen und an den Zuhörer gesendet.
Während das Meeting noch ausreichend von Ihrer Sprache sammelt, um Ihre Stimme zu modellieren (etwa in den ersten 5–10 Sekunden), verwendet die Synthese das Audio-Fragment, das dem entspricht, was Sie gerade in Ihrer Ausgangssprache gesagt haben. Sobald ein ausreichend langes Sample vorliegt, wechselt es dazu, dieses Sample für alles danach zu verwenden. In der Praxis bemerken Sie keinen Wechsel — die Übersetzung klingt im Laufe des Gesprächs immer mehr wie Sie. Es wird keine fehlerfreie Imitation Ihrer Stimme sein, aber es ist unverkennbar Sie und kein generischer Sprecher — und es wird immer besser, je mehr das Modell von Ihnen hört.
Sprachen
Die Übersetzung mit der eigenen Stimme ist für alle 23 Sprachen verfügbar — dieselbe Auswahl, die unter Sprachen auswählen aufgeführt ist. Es muss nichts separat aktiviert werden: Wenn die Übersetzung aktiviert ist, hören die Teilnehmer Sie automatisch mit Ihrer eigenen Stimme.
Ihr gespeichertes Stimm-Sample (optional)
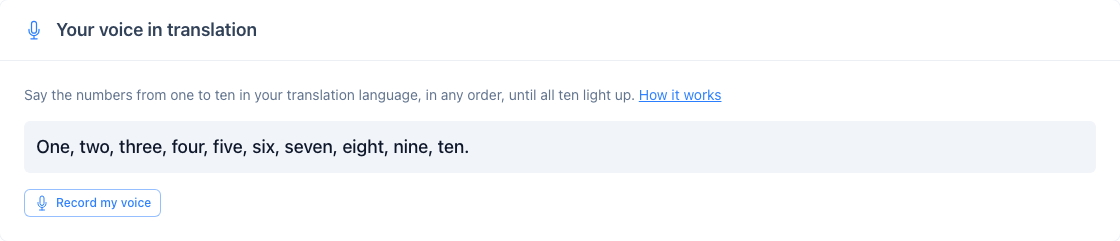
Angemeldete Benutzer können das Aufwärmen überspringen, indem sie ein Stimm-Sample einmalig unter Einstellungen → Ihre Stimme in der Übersetzung aufnehmen: Drücken Sie Meine Stimme aufnehmen, sagen Sie die Zahlen von eins bis zehn in beliebiger Reihenfolge, und das Sample speichert sich automatisch, sobald alle zehn aufleuchten. Ab Ihrem nächsten Meeting wird Ihre übersetzte Sprache ab dem ersten Satz damit vertont.
Datenschutz
Zwei Samples, zwei Lebensdauern. Das Live-Sample, das für das Aufwärmen im Meeting verwendet wird, ist temporär: Es existiert nur für die Dauer des Live-Meetings und wird nirgendwo gespeichert; die Mind API und das SDK, die die Echtzeit-Sitzung betreiben, behalten keine Daten, sobald die Konferenzsitzung endet. Das gespeicherte Sample aus den Einstellungen wird mit Ihrem Konto für einen einzigen Zweck gespeichert: der Vertonung Ihrer übersetzten Sprache. Es wird jedes Mal an die Übersetzungs-Engine gesendet, wenn Sie an einem Meeting teilnehmen, und in dem Moment gelöscht, in dem Sie es entfernen oder Ihr Konto löschen. Keines der beiden gehört zu den Video- und Sprach-Aufzeichnungsfunktionen von InterMIND, bei denen es sich um separate, bewusst gestartete Aufzeichnungen handelt.
Auf der Roadmap: Lip-Sync
Die Übersetzung mit der eigenen Stimme zu hören, ist die erste Hälfte eines größeren Ziels. Der nächste Schritt, an dem wir arbeiten, ist der Lip-Sync — eine Neu-Timung der Mundbewegungen des Sprechers im Kamerabild, um sie an das übersetzte Audio anzupassen, sodass jeder Teilnehmer so wirkt, als spräche er die Sprache des anderen. In Kombination mit der Übersetzung mit der eigenen Stimme besteht das Ziel in einem Gespräch, bei dem Personen, die keine gemeinsame Sprache haben, einander so sehen und hören, als spräche jeder von Natur aus die Sprache des anderen.
Dies ist ein Punkt auf der Roadmap und noch kein veröffentlichtes Feature — die oben genannte Übersetzung mit der eigenen Stimme ist heute bereits live.