
Suara Anda Sendiri
Suara Anda Sendiri
Saat InterMIND menerjemahkan ucapan Anda untuk peserta lain, mereka tidak mendengar narator text-to-speech robotik. Mereka mendengar suara yang jelas milik Anda — membawa karakter suara dan cara berbicara Anda — kini mengucapkan kata-kata tersebut dalam bahasa mereka.
Hal ini bekerja dalam kedua arah dan untuk setiap peserta secara independen. Dalam rapat di mana lima orang berbicara dalam lima bahasa, setiap orang mendengar empat orang lainnya dalam bahasa mereka sendiri, dan keempatnya tetap terdengar seperti diri mereka sendiri.
Seperti Apa Bunyinya
Sebagian besar alat terjemahan langsung menggantikan pembicara dengan satu suara sintetis generik. Hasilnya dapat dipahami namun datar — Anda kehilangan siapa yang berbicara, penekanan, kepribadian. InterMIND mempertahankan suara pembicara, sehingga rapat yang diterjemahkan terasa seperti percakapan antara orang-orang yang benar-benar berada di dalamnya, bukan antrean pengumuman yang dibacakan oleh mesin.
Cara Kerjanya
InterMIND menggunakan pipeline berjenjang, dan langkah suara adalah tahap terakhir:
- Pengenalan ucapan — kata-kata Anda ditranskripsi dalam bahasa Anda sendiri, saat Anda berbicara.
- Segmentasi — transkrip dikelompokkan menjadi fragmen kalimat yang stabil (klausa) sehingga penerjemahan dapat dimulai sebelum Anda selesai berbicara.
- Penerjemahan — setiap fragmen diterjemahkan secara progresif ke bahasa pendengar.
- Sintesis suara — setiap fragmen yang diterjemahkan diucapkan kembali menggunakan sampel suara Anda sendiri, dan dikirim ke pendengar.
Sementara rapat masih mengumpulkan cukup ucapan Anda untuk memodelkan suara Anda (kira-kira 5–10 detik pertama), sintesis menggunakan fragmen audio yang cocok dengan apa yang baru saja Anda ucapkan dalam bahasa sumber Anda. Setelah ada sampel yang cukup panjang, sistem beralih untuk menggunakan sampel tersebut untuk semua yang datang setelahnya. Dalam praktiknya, Anda tidak menyadari adanya pergantian — terjemahannya terdengar semakin seperti Anda seiring berjalannya panggilan. Ini tidak akan menjadi tiruan sempurna dari suara Anda, tetapi terdengar jelas seperti Anda, bukan narator generik — dan terus meningkat seiring model mendengar lebih banyak ucapan Anda.
Bahasa
Terjemahan suara-anda-sendiri tersedia untuk semua 23 bahasa suara — set yang sama tercantum di Memilih Bahasa. Tidak ada yang perlu diaktifkan secara terpisah: saat penerjemahan aktif, peserta secara otomatis mendengar Anda dalam suara Anda sendiri.
Sampel Suara Tersimpan Anda (Opsional)
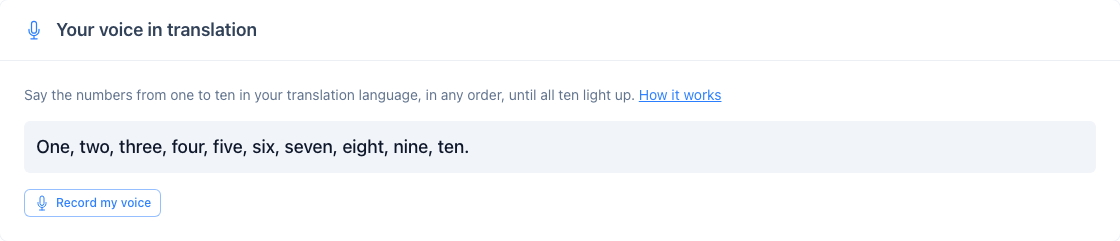
Pengguna yang telah masuk dapat melewati pemanasan dengan merekam sampel suara sekali di Pengaturan → Your voice in translation: tekan Rekam suara saya, ucapkan angka satu sampai sepuluh dalam urutan apa pun, dan sampel tersimpan sendiri saat semua sepuluh menyala. Dari rapat berikutnya, ucapan Anda yang diterjemahkan disuarakan dengannya mulai dari kalimat pertama.
Privasi
Dua sampel, dua masa hidup. Sampel langsung yang digunakan untuk pemanasan dalam rapat bersifat sementara: hanya ada selama rapat langsung berlangsung dan tidak disimpan di mana pun; Mind API dan SDK yang mendukung sesi real-time tidak menyimpan data apa pun setelah sesi konferensi berakhir. Sampel tersimpan dari Pengaturan disimpan dengan akun Anda untuk satu tujuan, yaitu menyuarakan ucapan Anda yang diterjemahkan, dikirim ke mesin penerjemahan setiap kali Anda bergabung ke rapat, dan dihapus saat Anda menghapusnya atau menghapus akun Anda. Keduanya bukan bagian dari fitur rekaman video dan suara InterMIND, yang merupakan rekaman terpisah dan eksplisit yang Anda mulai dengan sengaja.
Dalam Roadmap: Lip-Sync
Mendengar terjemahan dalam suara Anda sendiri adalah separuh dari tujuan yang lebih besar. Langkah berikutnya yang sedang kami kerjakan adalah lip-sync — menyesuaikan kembali waktu gerak mulut pembicara di kamera agar sesuai dengan audio yang diterjemahkan, sehingga setiap peserta tampak seolah berbicara dalam bahasa lawan bicaranya. Dikombinasikan dengan terjemahan suara-anda-sendiri, tujuannya adalah panggilan di mana orang-orang yang tidak berbagi bahasa yang sama dapat saling melihat dan mendengar seolah masing-masing berbicara dalam bahasa lawan bicaranya secara native.
Ini berada dalam roadmap, bukan fitur yang sudah dirilis — terjemahan suara-anda-sendiri di atas sudah aktif hari ini.