
Din egen stemme
Din egen stemme
Når InterMIND oversetter talen din for en annen deltaker, hører de ikke en robotaktig tekst-til-tale-forteller. De hører en stemme som er gjenkjennelig din – med din klangfarge og din måte å snakke på – som nå sier ordene på deres språk.
Dette fungerer i begge retninger og for hver deltaker uavhengig. I et møte der fem personer snakker fem språk, hører hver person de fire andre på sitt eget språk, og hver av de fire høres fortsatt ut som seg selv.
Slik høres det ut
De fleste verktøy for direkteoversettelse erstatter taleren med én enkelt generisk syntetisk stemme. Resultatet er forståelig, men flatt – du mister hvem som snakker, trykket og personligheten. InterMIND beholder talerens stemme, slik at et oversatt møte føles som en samtale mellom menneskene som faktisk deltar, ikke en kø av kunngjøringer lest opp av en maskin.
Slik fungerer det
InterMIND bruker en kaskadepipeline, og stemmesteget er det siste trinnet:
- Talegjenkjenning – ordene dine transkriberes på ditt eget språk mens du snakker.
- Segmentering – transkripsjonen grupperes i stabile setningsfragmenter (leddsetninger), slik at oversettelsen kan begynne før du er ferdig med setningen.
- Oversettelse – hvert fragment oversettes fortløpende til lytterens språk.
- Stemmesyntese – hvert oversatte fragment leses opp med en prøve av din egen stemme og sendes til lytteren.
Mens møtet fortsatt samler nok av talen din til å modellere stemmen din (omtrent de første 5–10 sekundene), bruker syntesen lydfragmentet som tilsvarer det du nettopp sa på kildespråket ditt. Når prøven er lang nok, bytter den til å bruke den prøven til alt som kommer etter. I praksis merker du ikke byttet – oversettelsen høres mer ut som deg etter hvert som samtalen går. Den blir ikke et feilfritt imitat av stemmen din, men den er gjenkjennelig deg i stedet for en generisk forteller – og den blir stadig bedre jo mer modellen hører av deg.
Språk
Oversettelse med din egen stemme er tilgjengelig for alle 23 talespråkene – det samme settet som er oppført i Velge språk. Det er ingenting som må slås på separat: når oversettelse er slått på, hører deltakerne deg automatisk med din egen stemme.
Din lagrede stemmeprøve (valgfritt)
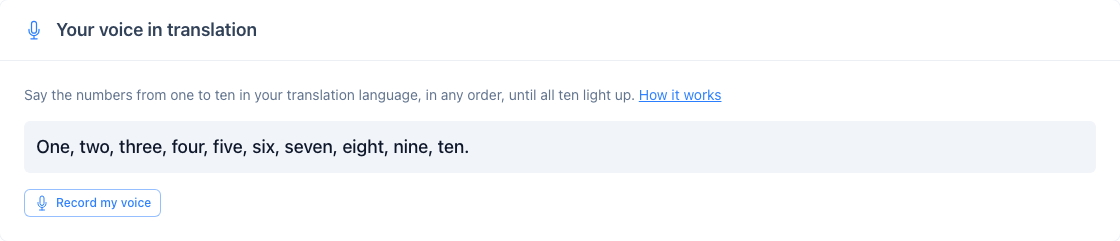
Innloggede brukere kan hoppe over oppvarmingen ved å spille inn en stemmeprøve én gang i Innstillinger → Stemmen din i oversettelse: trykk på Record my voice, si tallene fra én til ti i hvilken som helst rekkefølge, og prøven lagres av seg selv når alle ti lyser. Fra og med neste møte får den oversatte talen din stemmen din fra første setning.
Personvern
To prøver, to levetider. Den levende prøven som brukes til oppvarmingen under møtet, er flyktig: den finnes bare så lenge det levende møtet pågår og lagres ikke noe sted; Mind API og SDK som driver sanntidsøkten, beholder ingen data etter at konferanseøkten er slutt. Den lagrede prøven fra Innstillinger lagres sammen med kontoen din til ett formål, å gi den oversatte talen din stemme, sendes til oversettelsesmotoren hver gang du blir med i et møte, og slettes i det øyeblikket du fjerner den eller sletter kontoen din. Ingen av dem er en av InterMINDs funksjoner for opptak av video og lyd – de er separate, eksplisitte opptak som du starter med vilje.
På veikartet: leppesynkronisering
Å høre oversettelsen med din egen stemme er første halvdel av et større mål. Neste steg vi jobber mot, er leppesynkronisering – å justere timingen på talerens munn i kamerabildet slik at den passer til den oversatte lyden, så hver deltaker ser ut til å snakke den andres språk. Sammen med oversettelse med egen stemme er målet en samtale der folk som ikke har noe felles språk, ser og hører hverandre som om hver av dem snakket den andres språk som morsmål.
Dette er et punkt på veikartet, ikke en funksjon som er lansert ennå – oversettelse med egen stemme som beskrevet over er tilgjengelig i dag.