
您自己的声音
您自己的声音
当 InterMIND 将您的语音翻译给其他与会者时,他们听到的不是机械的文本转语音旁白。他们听到的是一种极具您个人辨识度的声音——保留您的音色和说话方式——只是现在正在用他们的语言说出这些话。
这种机制双向有效,且对每位与会者独立运作。在一场有五个人使用五种语言的会议中,每个人都能用自己的语言听到其他四个人的发言,而且这四个人中的每一个听起来都像是他们原本的声音。
听起来是什么效果
大多数实时翻译工具会用单一的通用合成语音替代发言人。结果虽然能够听懂,但显得平淡无奇——您会分不清是谁在说话、失去语气的强调和个性。InterMIND 保留了发言人的声音,因此一场经过翻译的会议感觉就像真正参与其中的人们在交谈,而不是由机器朗读的一连串播报。
工作原理
InterMIND 采用级联流水线(cascaded pipeline),语音合成是最后一个阶段:
- 语音识别 — 在您说话时,您的话语会被转录为您自己的语言。
- 句段切分 — 转录的文本会被分组为稳定的句子片段(分句),以便在您说完整句话之前就能开始翻译。
- 翻译 — 每个片段会逐步翻译成听众的语言。
- 语音合成 — 每个翻译后的片段会使用您自己的声音样本合成为语音并发送给听众。
在会议仍在收集足够的语音以建立您的声音模型期间(大约最初的 5–10 秒),合成阶段会使用与您刚刚用源语言说出的内容相匹配的音频片段。一旦有了足够长的样本,它就会切换为使用该样本来合成之后的全部内容。在实际体验中,您几乎察觉不到这种切换——随着通话的进行,翻译的声音会越来越像您自己。虽然这不会是对您声音的完美复刻,但听起来明显是您,而不是一个通用的旁白——而且随着模型听到更多您的声音,效果会不断提升。
语言支持
您自己的声音翻译支持所有 23 种语音语言——与选择语言中列出的语言集相同。无需单独启用:当开启翻译时,与会者会自动听到用您自己的声音合成的翻译。
您保存的声音样本(可选)
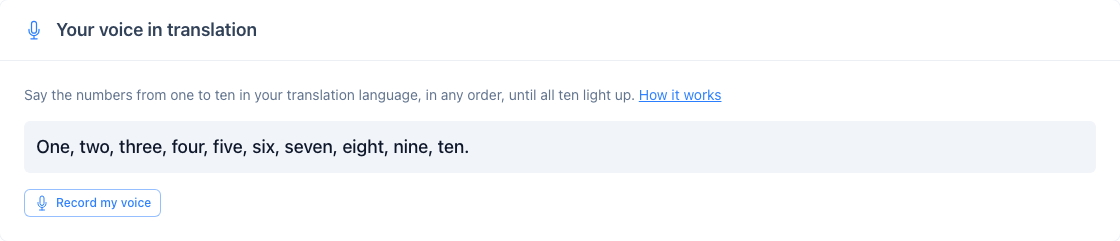
已登录的用户可以在设置 → 翻译中的声音中录制一次声音样本,从而跳过预热过程:按下录制我的声音,以任意顺序说出 1 到 10 的数字,当 10 个数字全部亮起时,样本会自动保存。从您的下一次会议开始,您的翻译语音将从第一句话起就使用该样本进行合成。
隐私
两种样本,两种生命周期。用于会议中预热的实时(live)样本是临时性的:它仅在实时会议期间存在,不会在任何地方存储;为实时会话提供支持的 Mind API 和 SDK 在会议结束后不保留任何数据。来自设置的已保存(saved)样本与您的账户一起存储,仅用于为您的翻译语音合成发声,每次您加入会议时都会发送到翻译引擎,并且在您移除它或删除账户的那一刻被删除。这两者都不属于 InterMIND 的视频和语音录制功能,后者是您特意启动的独立、明确的录音。
路线图规划:唇形同步
用您自己的声音听到翻译只是一个更宏大目标的前半部分。我们正在推进的下一步是唇形同步——重新调整镜头中发言人嘴部的动作时间,使其与翻译后的音频相匹配,这样每位与会者看起来都像是在说对方的语言。结合您自己的声音翻译,我们的目标是打造这样一种通话体验:没有共同语言的人们在看到和听到对方时,就像每个人都在以母语说对方的语言一样自然。
这是路线图中的一项,尚未发布为正式功能——而上方的您自己的声音翻译目前已正式上线。