
Suara Anda Sendiri
Suara Anda Sendiri
Apabila InterMIND menterjemahkan ucapan anda untuk peserta lain, mereka tidak mendengar pengisah teks-ke-suara yang kedengaran seperti robot. Mereka mendengar suara yang jelas seperti suara anda — dengan timbre dan gaya percakapan anda — kini menyebut kata-kata itu dalam bahasa mereka.
Ini berfungsi dua hala dan untuk setiap peserta secara bebas. Dalam meeting yang dihadiri lima orang dengan lima bahasa, setiap orang mendengar empat yang lain dalam bahasanya sendiri, dan setiap daripada empat orang itu masih kedengaran seperti diri mereka sendiri.
Bunyinya
Kebanyakan alat terjemahan langsung menggantikan penutur dengan satu suara sintetik generik. Hasilnya boleh difahami tetapi hambar — anda kehilangan identiti penutur, penekanan dan personalitinya. InterMIND mengekalkan suara penutur, supaya meeting yang diterjemahkan terasa seperti perbualan antara orang yang benar-benar menyertainya, bukan barisan pengumuman yang dibacakan oleh mesin.
Cara Ia Berfungsi
InterMIND menggunakan saluran berperingkat (cascaded pipeline), dan langkah suara ialah peringkat terakhir:
- Pengecaman pertuturan — kata-kata anda ditranskripsikan dalam bahasa anda sendiri, semasa anda bercakap.
- Segmentasi — transkrip dikumpulkan menjadi serpihan ayat yang stabil (klausa) supaya terjemahan boleh bermula sebelum anda habis menyebut ayat.
- Terjemahan — setiap serpihan diterjemahkan secara progresif ke dalam bahasa pendengar.
- Sintesis suara — setiap serpihan yang diterjemahkan dituturkan semula menggunakan sampel suara anda sendiri, dan dihantar kepada pendengar.
Semasa meeting masih mengumpulkan pertuturan anda yang mencukupi untuk memodelkan suara anda (kira-kira 5–10 saat pertama), sintesis menggunakan serpihan audio yang sepadan dengan apa yang baru anda katakan dalam bahasa sumber anda. Setelah sampel yang cukup panjang tersedia, sintesis beralih kepada sampel itu untuk semua yang selepasnya. Dalam praktiknya anda tidak perasan peralihan itu — terjemahan semakin kedengaran seperti anda apabila panggilan berlangsung. Ia tidak akan menjadi tiruan suara anda yang sempurna, tetapi ia jelas kedengaran seperti anda dan bukan pengisah generik — dan ia terus bertambah baik apabila model mendengar lebih banyak suara anda.
Bahasa
Terjemahan dengan suara anda sendiri tersedia untuk semua 23 bahasa suara — set yang sama seperti yang disenaraikan dalam Memilih Bahasa. Tiada apa-apa yang perlu diaktifkan secara berasingan: apabila terjemahan dihidupkan, peserta secara automatik mendengar anda dengan suara anda sendiri.
Sampel Suara Tersimpan Anda (Pilihan)
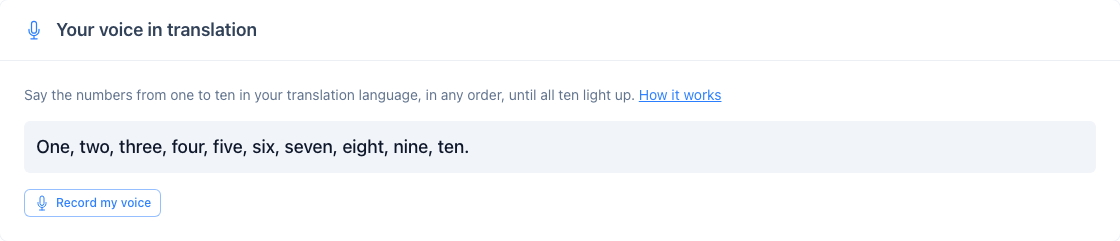
Pengguna yang telah log masuk boleh melangkau tempoh pemanasan dengan merakam sampel suara sekali sahaja di Tetapan → Suara anda dalam terjemahan: tekan Record my voice, sebut nombor satu hingga sepuluh mengikut sebarang susunan, dan sampel akan tersimpan sendiri apabila kesemua sepuluh menyala. Mulai meeting anda yang seterusnya, ucapan terjemahan anda disuarakan dengan sampel itu sejak ayat pertama.
Privasi
Dua sampel, dua tempoh hayat. Sampel langsung yang digunakan untuk pemanasan dalam meeting bersifat sementara: ia wujud hanya sepanjang meeting langsung dan tidak disimpan di mana-mana; Mind API dan SDK yang menggerakkan sesi masa nyata tidak menyimpan sebarang data setelah sesi persidangan tamat. Sampel tersimpan daripada Tetapan disimpan bersama akaun anda untuk satu tujuan sahaja, iaitu menyuarakan ucapan terjemahan anda, dihantar kepada enjin terjemahan setiap kali anda menyertai meeting, dan dipadam sebaik sahaja anda mengeluarkannya atau memadam akaun anda. Kedua-duanya bukan ciri rakaman video dan suara InterMIND, yang merupakan rakaman berasingan dan jelas yang anda mulakan dengan sengaja.
Dalam Peta Jalan: Lip-Sync
Mendengar terjemahan dengan suara anda sendiri ialah separuh pertama daripada matlamat yang lebih besar. Langkah seterusnya yang sedang kami usahakan ialah lip-sync — menyelaraskan semula masa gerakan mulut penutur pada kamera supaya sepadan dengan audio terjemahan, agar setiap peserta kelihatan bercakap dalam bahasa orang lain. Digabungkan dengan terjemahan suara sendiri, matlamatnya ialah panggilan yang membolehkan orang yang tidak berkongsi bahasa yang sama melihat dan mendengar satu sama lain seolah-olah masing-masing bertutur dalam bahasa orang lain secara asli.
Ini ialah item peta jalan, bukan ciri yang telah dilancarkan lagi — terjemahan dengan suara sendiri di atas sudah tersedia hari ini.