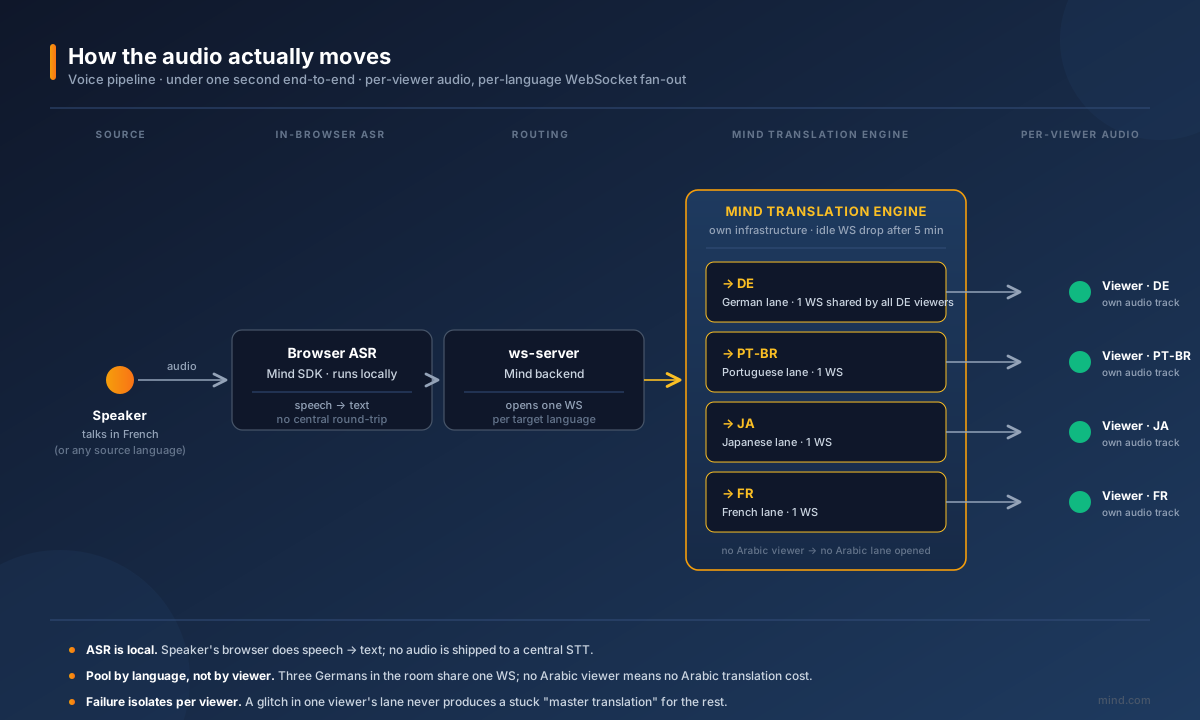
Así funcionan los cuatro pipelines de traducción que mueven InterMIND
La antigua página /product/overview/how-it-works de mind.com lleva varias versiones mayores sin actualizarse. Describe un único «motor de traducción», como hacen casi todas las páginas de proveedores: una gran flecha que va de «usted habla» a «ellos escuchan». Esa imagen ya era una simplificación hace dos años. Hoy es incorrecta.
En realidad, InterMIND ejecuta cuatro pipelines de traducción independientes. Cada uno resuelve un problema distinto, con un motor distinto, un presupuesto de latencia distinto y un margen de calidad distinto. Comparten el selector de idioma. No comparten motor.
Esta es la respuesta actualizada a la pregunta «¿cómo funciona?».
Un artículo complementario: «¿Cuántos idiomas admiten?» explica qué cubre cada pipeline (23 / 23 / 30 / 17). Este artículo explica qué hace cada pipeline y por qué es una pieza independiente.
Por qué «un solo motor para todo» es un error
Una plataforma de reuniones en directo tiene que hacer al menos cuatro tareas a la vez, y tiran en direcciones incompatibles:
- Voz en tiempo real: entra audio y sale audio traducido mientras el orador sigue hablando, con cada espectador en su propio idioma. La restricción principal es la latencia.
- Texto de chat en tiempo real: mensajes breves y rápidos, con ediciones, citas y estructura HTML conservadas.
- Notas compartidas en tiempo real: escritura colaborativa carácter a carácter, con una jerarquía (listas, encabezados, casillas de verificación) que debe sobrevivir a la traducción.
- Archivos de documentos asíncronos: un PDF de 40 páginas soltado en el chat. Sin presupuesto de latencia. La restricción principal es la fidelidad: formato, tablas, números de página, tipografía.
Se puede construir una única llamada gigante a un LLM que intente hacer las cuatro cosas. Lo intentamos. Lo hace mal en las cuatro. El presupuesto de latencia de la voz exige que el modelo no piense; el presupuesto de fidelidad de los documentos exige que piense. Una edición de chat necesita un diff en el idioma del espectador; un PDF de 40 páginas necesita una conservación del formato que ningún modelo de generación por tokens ofrece.
Por eso ejecutamos cuatro. Aquí están, uno por uno.