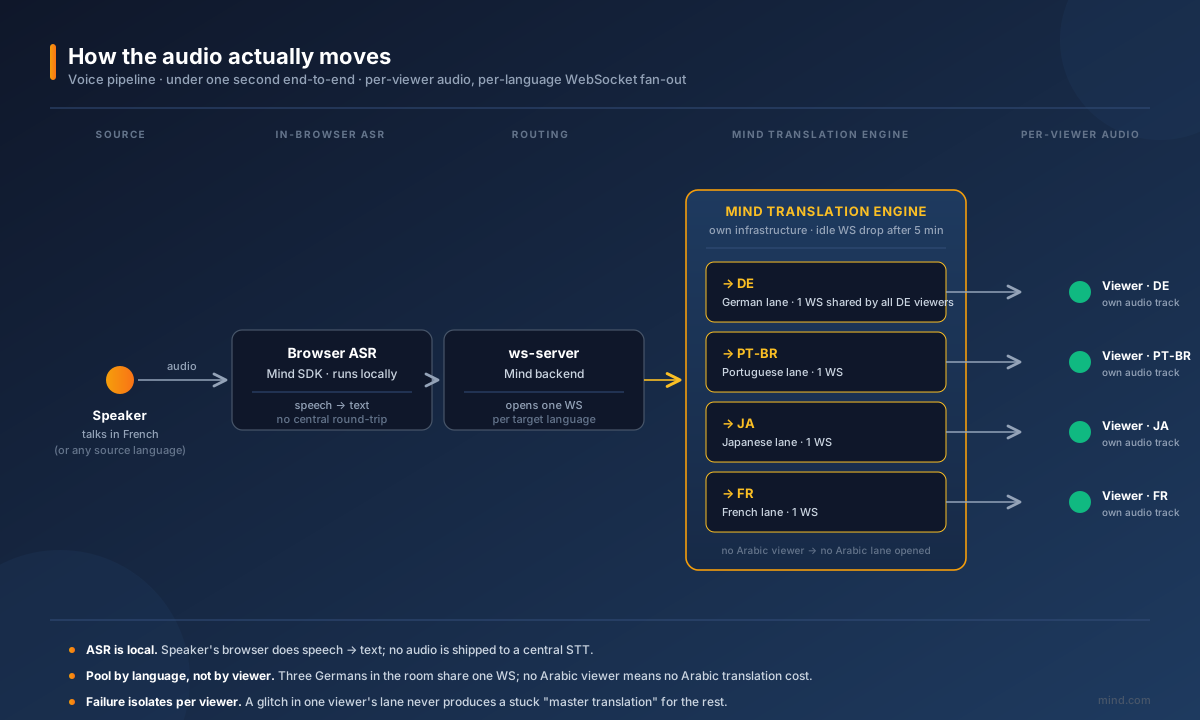
InterMINDを支える4つの翻訳パイプラインの内側
mind.com の旧ページ /product/overview/how-it-works は、現在の姿から数回のメジャーリリース分も古くなっています。このページは、多くのベンダーのページと同じように、単一の「翻訳エンジン」を説明していました。「あなたが話す」から「相手が聞く」へ向かう大きな矢印が一本あるだけの図です。2年前の時点でも、これは単純化しすぎた図でした。今では誤りです。
実際には、InterMINDは4つの独立した翻訳パイプラインを動かしています。それぞれ解く問題が異なり、エンジンも、レイテンシの許容値も、品質の範囲も異なります。共有しているのは言語ピッカーだけで、エンジンは共有していません。
これが「どのように動いているのか」への、更新された答えです。
関連記事: 「対応言語は何言語ですか?」では、各パイプラインがカバーする範囲(23 / 23 / 30 / 17)を扱っています。この記事では、各パイプラインが何をするのか、そしてなぜそれぞれが独立した存在なのかを説明します。
「すべてを一つのエンジンで」が嘘である理由
ライブのミーティングプラットフォームは、少なくとも4つの仕事を同時にこなす必要があり、それらは互いに相容れない方向へ引っ張り合います。
- リアルタイム音声 — 音声を入力すると、話者がまだ話している間に翻訳された音声が出力され、すべての視聴者がそれぞれの言語で聞きます。厳しい制約はレイテンシです。
- リアルタイムのチャットテキスト — 短いメッセージを素早く処理しつつ、編集、引用、HTML構造を保ちます。
- リアルタイムの共有ノート — 1文字ずつの共同入力に対応し、構造的な階層(リスト、見出し、チェックボックス)を翻訳後も維持する必要があります。
- 非同期のドキュメントファイル — チャットに投下された40ページのPDFです。レイテンシの制約はありません。厳しい制約は忠実度で、書式、表、ページ番号、フォントが対象です。
この4つすべてをこなそうとする巨大なLLM呼び出しを1つ作ることもできます。私たちは試しましたが、4つとも不得意でした。音声のレイテンシ予算ではモデルは考える余裕がなく、ドキュメントの忠実度予算ではモデルが考えなければなりません。チャットの編集には閲覧者の言語での差分が必要で、40ページのPDFには、トークンをストリーミングするどのモデルにも提供できない書式の保持が必要です。
そこで私たちは4つを動かしています。以下がそれぞれの説明です。