Ein Blick in die vier Übersetzungs-Pipelines von InterMIND

Die Übersetzung gibt es bei InterMIND nicht. Es gibt vier Pipelines – Voice, Chat, Notizen und Dokumente – jede mit eigener Engine, eigenem Latenzbudget und eigenem Qualitätsrahmen. So läuft es tatsächlich ab: vom Moment, in dem Sie sprechen, bis zu dem Moment, in dem ein Teilnehmer in einer anderen Sprache Sie versteht.

The Mind.com Team

Ein Blick in die vier Übersetzungs-Pipelines von InterMIND

Ein Blick in die vier Übersetzungs-Pipelines hinter InterMIND

Die alte Seite /product/overview/how-it-works auf mind.com ist mehrere Major-Releases veraltet. Sie beschreibt eine einzige „Übersetzungs-Engine“, so wie es die meisten Anbieterseiten tun: ein großer Pfeil von „Sie sprechen“ zu „die anderen hören“. Schon vor zwei Jahren war dieses Bild eine Vereinfachung. Heute stimmt es nicht mehr.

Tatsächlich betreibt InterMIND vier getrennte Übersetzungs-Pipelines. Jede löst ein anderes Problem, mit einer eigenen Engine, einem eigenen Latenzbudget und einem eigenen Qualitätsrahmen. Sie teilen sich eine Sprachauswahl. Eine Engine teilen sie sich nicht.

Das ist die aktualisierte Antwort auf die Frage „Wie funktioniert das?“.

Ein Begleitartikel: „Wie viele Sprachen unterstützen Sie?“ beschreibt, was jede Pipeline abdeckt (23 / 23 / 30 / 17). Dieser Beitrag beschreibt, was jede Pipeline leistet – und warum sie ein eigener Baustein ist.


Warum „eine Engine für alles“ nicht funktioniert

Eine Plattform für Live-Meetings muss mindestens vier Aufgaben gleichzeitig erfüllen, und sie ziehen in unvereinbare Richtungen:

  1. Sprache in Echtzeit – Audio geht hinein, übersetztes Audio kommt heraus, während die sprechende Person noch redet, und zwar für jede Zuhörerin und jeden Zuhörer in der eigenen Sprache. Die harte Randbedingung ist die Latenz.
  2. Chat-Text in Echtzeit – kurze Nachrichten, schnell, mit erhaltenen Bearbeitungen, Zitaten und HTML-Struktur.
  3. Gemeinsame Notizen in Echtzeit – kollaboratives Tippen Zeichen für Zeichen, mit einer Struktur (Listen, Überschriften, Checkboxen), die die Übersetzung überstehen muss.
  4. Asynchrone Dokumentdateien – ein PDF mit 40 Seiten, das in den Chat gelegt wird. Kein Latenzbudget. Die harte Randbedingung ist die Formatttreue – Formatierung, Tabellen, Seitenzahlen, Schriftart.

Man kann einen einzigen riesigen LLM-Aufruf bauen, der alle vier Aufgaben übernehmen soll. Wir haben es versucht. Er ist bei allen vieren schlecht. Das Latenzbudget für Sprache bedeutet, dass das Modell nicht nachdenken kann; das Treuebudget für Dokumente bedeutet, dass es nachdenken muss. Eine Chat-Bearbeitung braucht einen Diff in der Sprache der Betrachterin oder des Betrachters; ein PDF mit 40 Seiten braucht eine Formaterhaltung, die kein Token-Streaming-Modell liefert.

Also betreiben wir vier. Hier ist jede einzelne.

Pipeline 1: Sprachübersetzung in Echtzeit

Das Problem: Eine Person spricht Französisch. Eine zweite ist auf Deutsch beigetreten, eine dritte auf brasilianischem Portugiesisch, eine vierte auf Japanisch. Jede und jeder soll die sprechende Person in der eigenen Sprache hören, im eigenen Ohr, mit einer Verzögerung, die kurz genug ist, um Blickkontakt zu ermöglichen.

Das Budget: Die Zuhörenden dürfen nie darauf warten müssen. Sobald die übersetzte Sprache so weit hinterherhinkt, dass die Leute anfangen, dazwischenzureden, driftet das Meeting in Richtung „Lasst uns einfach auf Englisch wechseln“.

Wie das Audio tatsächlich läuft

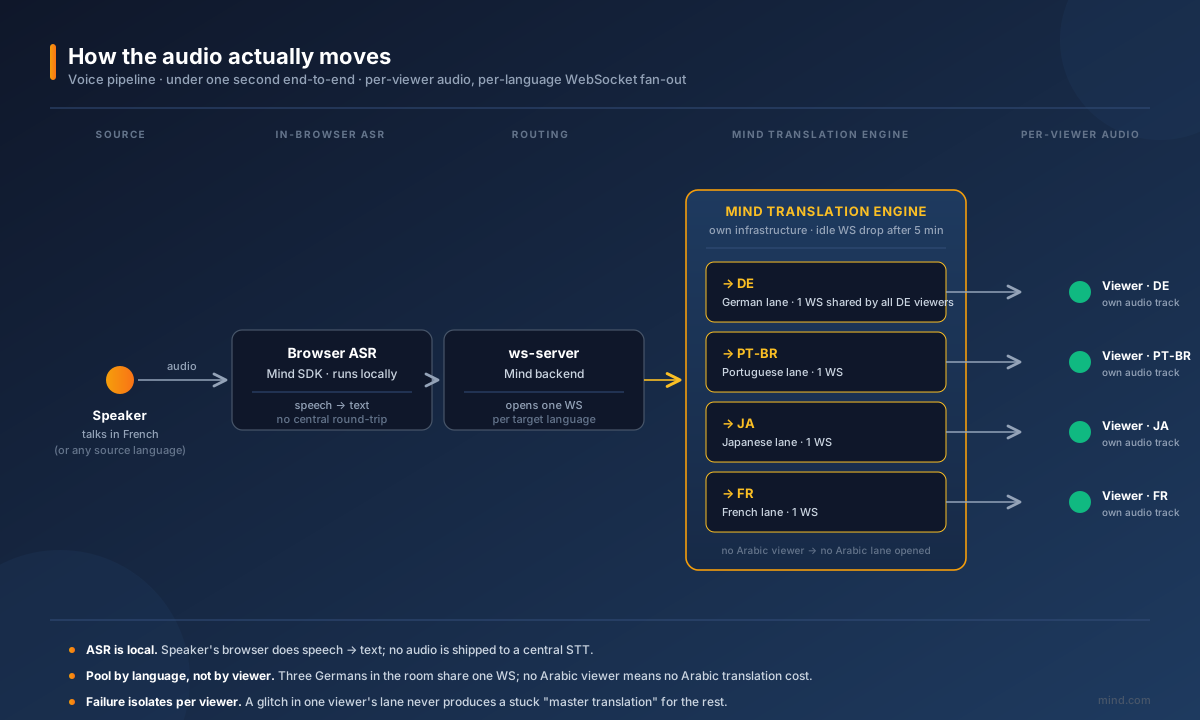
Pipeline der Sprachübersetzung: Der Browser der sprechenden Person sendet Audio über WebRTC an unsere eigene Engine – den Media-Server der Mind API bei OVH in Frankreich –, die ASR ausführt und in jede im Raum vorhandene Zielsprache übersetzt; jede Zuschauerin und jeder Zuschauer erhält die eigene übersetzte Audiospur, und der ws-server erhält die Transkriptwörter für das Besprechungsprotokoll.

Ein paar Dinge verdienen es, ausdrücklich genannt zu werden:

  • ASR läuft auf dem Media-Server. Das Audio der sprechenden Person wandert über WebRTC zu unserer eigenen Engine – der Mind API bei OVH in Frankreich – und wird dort erkannt, auf demselben Server, der den Call trägt; der Browser sendet nur Audio und erhält die Wörter zurück. Es gibt keinen separaten Sprachanbieter und keinen zusätzlichen Zwischenschritt, bevor die Übersetzung beginnen kann. (Sprachnotizen im Chat sind die Ausnahme: Ihre Spracherkennung läuft über Azure AI Speech, den Sprachdienst des Standard-AI-Gateways.)
  • Die Übersetzung ist kein einzelner Fan-out. Die Engine übersetzt pro im Raum vorhandener Zielsprache, nicht pro Zuschauer: Die Übersetzung in eine Sprache startet, sobald die erste zuhörende Person in dieser Sprache einen übersetzten Stream anfordert; drei Teilnehmende, die Deutsch gewählt haben, teilen sich eine deutsche Übersetzung, und wenn niemand auf Arabisch zuhört, wird nichts ins Arabische übersetzt. Deshalb kostet ein Meeting mit vier Sprachen genauso viel wie eines mit vierzig Sprachen, soweit es um die tatsächlich Anwesenden geht – wir übersetzen nie in Sprachen, in denen niemand zuhört.
  • Die synthetisierte Sprache ist pro Zuschauer. Jede teilnehmende Person erhält ihre eigene übersetzte Audiospur, gemischt mit dem Video der Originalsprecherin oder des Originalsprechers. Sie sehen kein zentrales „übersetztes Meeting“, sondern dasselbe Meeting, bei dem der persönliche Audiokanal in die gewählte Sprache übersetzt wird. Deshalb können zwei Personen im selben Raum jeweils Kopfhörer aufsetzen und unterschiedliche Sprachen hören.

Warum das wichtig ist, wenn ein Meeting aus dem Ruder läuft

In einem 60-minütigen Call mit acht Sprachen geht auf interessante Weise etwas schief: WebSockets brechen ab, die ASR erkennt einen Eigennamen vorübergehend falsch, die Verbindung einer Person wird wackelig. Die oben beschriebene Architektur ermöglicht es uns, Fehler zu isolieren: Wenn das Audio einer Zuschauerin oder eines Zuschauers stört, hat das keine Auswirkung auf die anderen sieben, weil die Übersetzungs-Engine nie „die Übersetzung“ erzeugt hat – sie hat acht parallel erzeugt, und nur die betroffene muss sich erholen.

Die Engine selbst gehört uns und läuft auf unserer eigenen Infrastruktur. Wir leiten Echtzeit-Sprache nicht über allgemeine LLMs von Drittanbietern. Das Latenzbudget schließt sie aus; und die Datenresidenz schließt sie für die regulierten Kunden aus, denen sie wirklich wichtig ist.

Was wir zur Sprachqualität veröffentlichen: /benchmark lässt die produktive Sprach-Pipeline monatlich gegen FLORES-200-Sätze für jedes veröffentlichte Sprachpaar laufen. Die Bewertungsinstanz ist benannt (Gemini 3.7 Flash primär, Claude Sonnet 5 als Fallback). Die vollständige Verteilung – Median, p10, p90, Minimum, Maximum, Stichprobengröße – steht auf der Seite. In der Methodik steht, was diese Zahlen messen und was nicht.


Pipeline 2: Chat-Übersetzung in Echtzeit

Das Problem: Jede Chatnachricht im Meeting wird für jede teilnehmende Person in deren Sprache übersetzt, sobald sie gesendet wird. Dazu kommen Bearbeitungen – und Bearbeitungen müssen wie Bearbeitungen aussehen, nicht wie Neuübersetzungen.

Das Budget: großzügiger als bei Sprache. Eine Chatnachricht darf einen Moment brauchen, um in einer anderen Sprache zu erscheinen, ohne dass es jemanden stört. Wichtig ist den Leuten, ob die Übersetzung stimmt und ob Bearbeitungen nachvollziehbar sind.

Was die Chat-Pipeline tatsächlich tut

Jede Nachricht durchläuft dieselbe Übersetzungs-Engine wie die Sprach-Pipeline – aber mit anderer Vor- und Nachverarbeitung:

  • Die HTML-Struktur bleibt erhalten. Der Chat unterstützt Rich Text (Absätze, Listen, Zitate, Fett, Kursiv). Wir wandeln für das Modell in reinen Text um, übersetzen und verpacken das Ergebnis dann wieder in die ursprünglichen Tags. Das Modell sieht nie das HTML – es sieht sauberen Fließtext.
  • Zitate werden unabhängig übersetzt. Wenn Sie auf eine Nachricht antworten und sie zitieren, werden der [QUOTE]…[/QUOTE]-Block und der neue Inhalt als getrennte Einheiten übersetzt, damit das Modell die beiden nicht verwechseln kann.
  • Lange Nachrichten werden in Chunks aufgeteilt. Wir teilen an Absatzgrenzen bei 1.000 Zeichen pro Chunk. Jeder Chunk ist ein eigener Übersetzungsaufruf. Wir füttern das Modell nicht mit 4.000 Zeichen langen Romanen auf einmal – die Fehlerbilder (Abschneiden, verlorene Absätze, Abbrüche mitten im Satz) sind zu hässlich.
  • Die Übersetzung erfolgt verzögert (Lazy). Wir verwenden einen IntersectionObserver: Eine Nachricht wird erst übersetzt, wenn sie in den Viewport der Betrachterin oder des Betrachters scrollt. Früher spielte ein Sprachwechsel in einem lange laufenden Channel jeden Übersetzungs-API-Aufruf aus dem Verlauf erneut ab. Jetzt nicht mehr.

Der interessante Teil: Bearbeitungen als Diffs

In v1.2 haben wir geändert, wie sich Chat-Bearbeitungen für Betrachtende in einer anderen Sprache verhalten. Das alte Verhalten: Jemand bearbeitet eine Nachricht, wir übersetzen das Ganze neu, Sie sehen einen frischen Absatz und müssen selbst herausfinden, was sich verschoben hat.

Das neue Verhalten:

  1. Die ursprüngliche Nachricht wurde bereits in Ihre Sprache übersetzt.
  2. Wenn die absendende Person bearbeitet, übersetzen wir die neue Version neu.
  3. Wir berechnen den Diff zwischen Ihrer bisherigen Übersetzung und Ihrer neuen Übersetzung, in Ihrer Sprache.
  4. Diesen Diff zeigen wir inline an – so, wie Git zeigt, was sich geändert hat.

Wenn also aus „review by Tuesday“ im Englischen „review by Thursday“ wird, sieht Ihre spanischsprachige Kollegin martes → jueves hervorgehoben, statt eines neu übersetzten Absatzes, den sie noch einmal lesen muss.

Dazu musste die Chat-Pipeline als zustandsbehafteter Cache pro Betrachter behandelt werden, nicht als zustandsloser Translate-on-Request-Endpunkt. Dokumente und Sprache brauchen das nicht. Der Chat schon.


Pipeline 3: Übersetzung gemeinsamer Notizen in Echtzeit

Das Problem: Der Host öffnet einen Bereich für gemeinsame Notizen und beginnt zu tippen. Alle Teilnehmenden sehen die Notizen in ihrer Sprache, Zeichen für Zeichen, mit intakter Struktur des Dokuments – Überschriften, verschachtelte Listen, Checklisten, Codeblöcke.

Das Budget: wie beim Chat, aber mit zwei zusätzlichen Randbedingungen:

  • Das, was übersetzt wird, ändert sich während der Übersetzung. Der Host tippt noch. Ein naives System, das bei jedem Tastenanschlag „das ganze Dokument“ übersetzt, erzeugt Flackern und verbrennt das API-Budget. Wir übersetzen in der Granularität der geänderten Einheit, nicht des ganzen Dokuments.
  • Die Struktur muss erhalten bleiben. Wenn Sie ein Übersetzungsmodell bitten, einen Markdown-Blob mit drei verschachtelten Listen zu übersetzen, bekommen Sie etwas zurück, das dem Original ähnlich sieht, aber mit unmerklich eingeebneter Hierarchie, neu nummerierten Einträgen oder verschobenen Einrückungen. Wir lassen das Modell nicht den ganzen Blob sehen.

Wie sich die Notizen-Pipeline vom Chat unterscheidet

Entscheidend ist der Erhalt der Struktur. Wir übersetzen jeden Listeneintrag einzeln statt als ein Dokument. Das Modell sieht:

„Compliance review — Q2 deliverables“

– und nicht:

„# Project plan\n## Quarter\n- Compliance review — Q2 deliverables\n- Vendor scoring\n - Tier 1 vendors...“

Das umgebende Dokument – das <ul>, die Überschriften, die Einrückung – wird auf der Client-Seite mit derselben Struktur wieder aufgebaut, die das Originaldokument hatte, wobei jeder Blattknoten durch seine Übersetzung ersetzt wird. Das Modell darf die Hierarchie nie „verbessern“.

Notizen nutzen außerdem dasselbe Diff-Modell pro Betrachter wie Chat-Bearbeitungen: Wenn der Host eine Zeile ändert, sehen Betrachtende in anderen Sprachen die geänderten Wörter hervorgehoben, nicht einen frischen Absatz.


Pipeline 4: Asynchrone Dokumentübersetzung

Das Problem: Jemand legt ein PDF mit 40 Seiten, ein Word-Dokument, eine PowerPoint-Präsentation oder eine Excel-Tabelle in den Chat. Jede teilnehmende Person kann eine Kopie in ihrer eigenen Sprache anfordern. Die übersetzte Datei muss aussehen wie das Original – dieselben Schriftarten, dieselben Tabellen, dieselben Seitenzahlen, dieselben Kopfzeilen, dieselben Diagramme an derselben Stelle.

Das Budget: Keine Echtzeit-Randbedingung. Eine Minute ist in Ordnung. Zwei Minuten sind in Ordnung. Die Randbedingung ist die Formattreue – wenn das übersetzte PDF nicht wie das Original aussieht, vertraut ihm die Empfängerin oder der Empfänger nicht.

Warum diese Pipeline keine Engine mit der Sprache teilt

Ein allgemeines LLM, selbst ein sehr gutes, liefert Ihnen einen übersetzten Text eines Dokuments. Es liefert Ihnen kein übersetztes PDF mit demselben Layout. Das Modell hat kein Konzept für einen „Seitenumbruch, der mit der Quelle übereinstimmen muss“ oder eine „Tabellenzelle, die ihre Spaltenbreite behalten muss“.

Für diese Oberfläche nutzen wir direkt die DeepL Document API. Sie wurde dafür gebaut, Dateien als Dateien zu übersetzen, nicht aus Dateien extrahierten Fließtext. DeepL verarbeitet:

  • PDF (mit Layouterhalt)
  • DOCX, DOC
  • PPTX
  • XLSX

Das Dokument wird in die Pipeline von DeepL hochgeladen, serverseitig mit intakter Formatierung übersetzt und im selben Format zurückgegeben. Das Ergebnis laden wir anschließend in unseren Objektspeicher hoch und stellen es im Chat als herunterladbaren Anhang bereit.

Was das kostet und warum wir es nicht verstecken

DeepL berechnet mindestens 50.000 Zeichen pro Dokument – etwa einen US-Dollar pro Datei im Pro-Tarif, unabhängig davon, ob das Dokument eine Seite oder dreißig umfasst. Diese Kosten tragen wir selbst, statt pro Datei etwas zu berechnen; sie erscheinen in der Übersetzungsnutzung des Meetings als abgerechnete Zeichen, umgerechnet in Worteinheiten, die zu der Art passen, wie der Rest des Produkts Übersetzungsaktivität ausweist.

Wir haben uns für diese Oberfläche für DeepL entschieden, weil das Übersetzen von Dateien als Dateien genau die Aufgabe ist, für die es gebaut wurde – wir haben nicht versucht, eine bessere zu bauen. Umgekehrt gilt das nicht: DeepL betreibt keine Live-Sprach-Pipeline von der Art, wie wir sie für Meetings gebaut haben. Verschiedene Probleme, verschiedene Werkzeuge. Die ehrliche Antwort auf „Was steckt hinter der Übersetzung in InterMIND?“ lautet „die passende Engine pro Pipeline“ – nicht „unsere Engine, überall“.

Sprachen, die diese Pipeline abdeckt und die Sprache nicht

Die Dokument-Pipeline erreicht 30 Sprachen, gegenüber 23 bei Sprache. Zu den zusätzlichen gehören: Bulgarisch, Griechisch, Estnisch, Indonesisch, Litauisch, Lettisch, Slowakisch, Slowenisch. (Arabisch steht ebenfalls auf dieser Liste und gehört zu den zusätzlichen: Es ist aus der Echtzeit-Auswahl herausgenommen, solange seine Sprachqualität unter unserer Messlatte liegt, und seine Werte pro Sprachpaar bleiben öffentlich auf /benchmark einsehbar – diese Zahl bringt es zurück. Bei Hindi verläuft die Asymmetrie in die andere Richtung – bei Sprache live, bei Dateien noch nicht.)

Diese Asymmetrie ist real. Sie bedeutet, dass ein französischer Teilnehmer in einem Meeting das Vertrags-PDF auf Estnisch anfordern kann, obwohl er dem Meeting nicht auf Estnisch zuhören kann. Wir weisen in der Auswahl darauf hin, statt es mit einer einzigen Zahl zu glätten. Die Begründung steht im Beitrag zur Sprachanzahl.


Wo sich die Pipelines treffen

Die vier Pipelines laufen nicht isoliert. Ein Meeting-Raum ist der Ort, an dem sie aufeinandertreffen, und auf die Übergänge kommt es an:

  • Eine Chatnachricht mit Dokumentanhang löst die Chat-Pipeline für den Text und die Dokument-Pipeline für die Datei aus. Die Person in einer anderen Sprache sieht die Nachricht sofort übersetzt, und die Übersetzung des Anhangs trifft asynchron als Download ein.
  • Eine gemeinsame Notiz, die eine Transkriptzeile zitiert, kreuzt Notizen ↔ Sprache. Das Transkript ist das, was die Sprach-Pipeline für die Sprache der sendenden Person erzeugt hat; die Notizübersetzung erzeugt für alle anderen eine Kopie dieses Zitats pro Betrachter in deren Sprache, mit erhaltener Quellenangabe.
  • Ein nach dem Meeting exportiertes Transkript lässt die Text-Pipeline im Chat-Stil über die gesamte Konversation laufen und erzeugt pro Sprache eine Datei, die die Teilnehmenden herunterladen können. Das ist derselbe Codepfad wie bei der Chat-Übersetzung, nur gebündelt.

Die Sprachauswahl ist ein einziges Stück Oberfläche. Die Infrastruktur darunter besteht aus vier Pipelines, die miteinander sprechen.


Was wir bewusst nicht versuchen

  • Kein „einheitliches Übersetzungsmodell“. Wir bauen nicht ein Modell, das Sprache, Chat, Notizen und Dokumente abdeckt. Beim Zielkonflikt zwischen Latenz und Treue gibt es keinen Gewinner. Wir setzen pro Oberfläche die passende Engine ein.
  • Kein stilles Umleiten. Wenn die Datei-Pipeline heute nicht ins Hindi übersetzen kann, fallen wir nicht heimlich auf die Sprach-Engine zurück und tun so, als hätte es funktioniert – die Dateiauswahl weist stattdessen auf die Lücke hin, statt sie zu verbergen.
  • Kein „Wir übersetzen in 200 Sprachen“. Unsere Engine gibt 24 aus. Die Live-Oberflächen liefern 23, Dokumente 30 – und statt einer werbewirksamen Einzelzahl wird die Qualität pro Sprachpaar, die vor einer Prüfinstanz Bestand haben muss, unter /benchmark veröffentlicht, schwächere Paare eingeschlossen.

Probieren Sie es selbst aus

  • Zur Live-Demo – lässt die Live-Sprach-Pipeline mit Ihrem Audio laufen, in jeder der 23 Produktsprachen. Es ist dieselbe Pipeline, die den /benchmark bewertet.
  • Zum Benchmark – Qualität pro Sprachpaar und Monat auf echtem Traffic. Jedes Paar der Auswahl, stark oder schwach, direkt verlinkbar.
  • Zur Methodik – was die Zahlen sind, was sie nicht sind, wer die Bewertungsinstanz ist.

Vier Pipelines, vier Engines, ein Meeting-Raum. Das ist der ehrliche Ersatz für die alte how-it-works-Seite.

— Das Mind.com-Team


Quellen: DeepL — supported languages, DeepL — usage count and billing (das Minimum von 50.000 Zeichen pro Datei), FLORES-200; interne Pipeline-Fakten gegen den ausgelieferten Code geprüft, Stand August 2026.

Mehr zu Live-Übersetzung

Alle Beiträge zu Live-Übersetzung
Englisch genügt für den Erstkontakt. Das Geschäft läuft in der Sprache des Partners
Live-Übersetzung

Englisch genügt für den Erstkontakt. Das Geschäft läuft in der Sprache des Partners

Wo Englisch im Exportgeschäft endet, Phase für Phase: Anfrage, Angebot, Verhandlung, Reklamation, Folgeauftrag. Was die Exportabteilung heute für die Sprache des Partners zahlt, mit Preisen und Quellen, und was danach beim Geschäft bleibt.

The Mind.com Team

Türkischer Sprachübersetzer: Das Verb kommt zuletzt – und das entscheidet, welchen Sie brauchen
Live-Übersetzung

Türkischer Sprachübersetzer: Das Verb kommt zuletzt – und das entscheidet, welchen Sie brauchen

Im Türkischen stehen das Verb – und die Verneinung und die Zeitform – am Ende des Satzes. Genau diese Tatsache trennt die drei Produkte, die als „Sprachübersetzer“ verkauft werden: Smartphone-Apps, Übersetzer-Earbuds und Live-Übersetzung in Meetings. Was jedes davon mit einem türkischen Satz leisten kann und was nicht – und warum die Sprachanzahl eines Anbieters über dieses Sprachpaar nichts aussagt.

The Mind.com Team

Simultandolmetscher: Mensch, RSI-Plattform oder KI — was Ihr mehrsprachiges Meeting braucht (2026)
Live-Übersetzung

Simultandolmetscher: Mensch, RSI-Plattform oder KI — was Ihr mehrsprachiges Meeting braucht (2026)

»Simultandolmetscher« ist der Beruf, »Simultanübersetzung« das, was die meisten suchen: Sprache, die während des Sprechens in einer anderen Sprache ankommt. Dieser Leitfaden trennt Kabine, RSI-Plattform und KI-Simultanübersetzung, vergleicht die Werkzeuge anhand ihrer Dokumentation — Interprefy, KUDO, Wordly, DeepL Voice, Zoom, Teams, Google Meet, InterMIND — und stellt die Frage, die Vergleiche auslassen: Wie viel des Meetings kommt wirklich in Ihrer Sprache zurück?

The Mind.com Team

Neue Beiträge und Produkt-Updates per E-Mail erhalten

Eine E-Mail pro Monat mit neuen Beiträgen und Produktupdates. Jederzeit abbestellen.