Een kijkje in de vier vertaalpipelines achter InterMIND

In InterMIND bestaat niet één "de vertaling". Er zijn vier pipelines — spraak, chat, notities en documenten — elk met een eigen engine, latentiebudget en kwaliteitsbereik. Dit is wat er werkelijk gebeurt tussen het moment dat je spreekt en het moment waarop een deelnemer in een andere taal je begrijpt.

The Mind.com Team

  • Vier pipelines, niet één engine. Spraak, chat, notities en documenten draaien elk op een eigen engine, met een eigen latentiebudget en een eigen kwaliteitsbereik. Alleen de taalkiezer delen ze.
  • Andere taken, andere engines. Spraak draait per doeltaal in de ruimte op onze eigen engine in Frankrijk. Documenten gaan naar de Document API van DeepL: 23 en 30 talen.
  • InterMIND houdt de hele meeting in de taal van elk lid: spraak, chat, notities en bestanden, met de kwaliteit per taalpaar maandelijks gepubliceerd. Gasten sluiten gratis aan via een link, zonder account. Je betaalt alleen voor actieve leden.
Een kijkje in de vier vertaalpipelines achter InterMIND

Een kijkje in de vier vertaalpipelines achter InterMIND

De oude pagina /product/overview/how-it-works op mind.com loopt meerdere grote releases achter. Ze beschrijft één enkele "vertaalengine", zoals de meeste leverancierspagina's doen: één grote pijl van "jij spreekt" naar "zij horen". Dat beeld was twee jaar geleden al een vereenvoudiging. Nu klopt het niet meer.

In werkelijkheid draait InterMIND vier afzonderlijke vertaalpipelines. Elk lost een ander probleem op, met een andere engine, een ander latentiebudget en een ander kwaliteitsbereik. Ze delen een taalkiezer. Ze delen geen engine.

Dit is het bijgewerkte antwoord op "hoe werkt het?".

Een aanvullend stuk: "Hoeveel talen ondersteunen jullie?" beschrijft wat elke pipeline dekt (23 / 23 / 30 / 17). Dit artikel beschrijft wat elke pipeline doet en waarom het een eigen pipeline is.


Waarom "één engine voor alles" een leugen is

Een platform voor live meetings heeft minstens vier taken tegelijk, en die trekken in onverenigbare richtingen:

  1. Realtime spraak: audio gaat erin, vertaalde audio komt eruit terwijl de spreker nog praat, voor elke kijker in zijn eigen taal. De harde eis is latentie.
  2. Realtime chattekst: korte berichten, snel, met behoud van bewerkingen, citaten en HTML-structuur.
  3. Realtime gedeelde notities: teken-voor-teken samen typen, met een structuurhiërarchie (lijsten, koppen, selectievakjes) die de vertaling moet overleven.
  4. Asynchrone documentbestanden: een pdf van 40 pagina's die in de chat wordt gezet. Geen latentiebudget. De harde eis is getrouwheid: opmaak, tabellen, paginanummers, lettertype.

Je kunt één gigantische LLM-aanroep bouwen die alle vier probeert te doen. Wij hebben het geprobeerd. Het model is slecht in alle vier. Het latentiebudget van spraak betekent dat het model niet kan nadenken. Het getrouwheidsbudget van documenten betekent dat het model dat juist moet doen. Een chatbewerking vraagt om een diff in de taal van de kijker. Een pdf van 40 pagina's vraagt om opmaakbehoud, en dat biedt geen enkel token-streamend model.

Dus draaien we er vier. Hier zijn ze.


Pipeline 1: Realtime spraakvertaling

Het probleem: Een deelnemer spreekt Frans. Een tweede deelnemer is in het Duits aangesloten, een derde in Braziliaans Portugees, een vierde in het Japans. Iedereen moet de spreker in zijn eigen taal horen, in zijn eigen oor, met een vertraging die kort genoeg is om oogcontact mogelijk te houden.

Het budget: de luisteraar mag er nooit op hoeven te wachten. Zodra vertaalde spraak zo ver achterloopt dat mensen er doorheen gaan praten, schuift de meeting op naar "laten we gewoon overstappen op Engels".

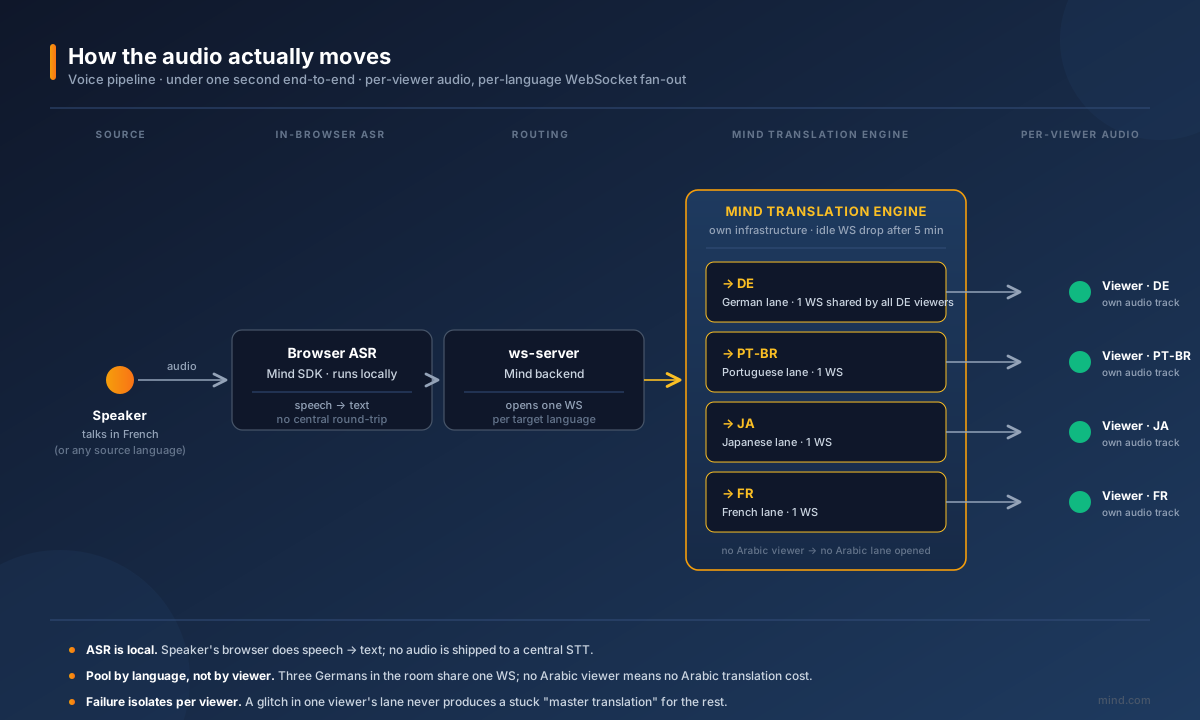
Hoe de audio zich werkelijk verplaatst

Spraakvertaalpipeline: de browser van de spreker stuurt audio via WebRTC naar onze eigen engine — de Mind API-mediaserver bij OVH in Frankrijk — die ASR uitvoert en vertaalt naar elke doeltaal die in de ruimte aanwezig is; elke kijker ontvangt zijn eigen vertaalde audiotrack, en de ws-server ontvangt de transcriptwoorden voor de recap.

Een paar dingen die we expliciet willen benoemen:

  • ASR draait op de mediaserver. De audio van de spreker reist via WebRTC naar onze eigen engine, de Mind API bij OVH in Frankrijk, en wordt daar herkend, op dezelfde server die het gesprek draagt. De browser stuurt alleen audio en ontvangt de woorden terug. Er is geen aparte spraakleverancier en geen extra tussenstap voordat de vertaling kan beginnen. (Spraakberichten in de chat zijn de uitzondering: de spraak-naar-tekst daarvan draait op Azure AI Speech, de spraakdienst van de standaard AI-gateway.)
  • Vertaling is niet één grote waaier. De engine vertaalt per doeltaal die in de ruimte aanwezig is, niet per kijker. De vertaling naar een taal start zodra de eerste luisteraar in die taal om een vertaalde stream vraagt. Drie deelnemers die Duits hebben gekozen, delen één Duitse vertaling. Luistert niemand in het Arabisch, dan wordt er niets naar het Arabisch vertaald. Daarom kost een meeting in vier talen hetzelfde als een meeting in veertig talen, voor zover het gaat om wie er daadwerkelijk is komen opdagen: we vertalen nooit naar talen waarin geen enkele deelnemer luistert.
  • Gesynthetiseerde spraak is per kijker. Elke deelnemer ontvangt zijn eigen vertaalde audiotrack, gemixt met de video van de oorspronkelijke spreker. Ze kijken niet naar een centrale "vertaalde meeting". Ze kijken naar dezelfde meeting, met een persoonlijk audiokanaal dat is vertaald naar de gekozen taal. Daarom kunnen twee mensen in dezelfde fysieke ruimte allebei een koptelefoon opzetten en verschillende talen horen.

Waarom dit uitmaakt als een meeting misgaat

In een gesprek van 60 minuten met acht talen gaan dingen op interessante manieren stuk: WebSockets vallen weg, ASR transcribeert tijdelijk een eigennaam verkeerd, het netwerk van één deelnemer wordt haperig. De bovenstaande architectuur maakt het mogelijk storingen te isoleren. Een haperende audiostream bij één kijker raakt de andere zeven niet, omdat de vertaalengine nooit "de vertaling" heeft geproduceerd. Ze produceerde er acht, parallel, en alleen de getroffen stream hoeft te herstellen.

De engine zelf is van ons en draait op onze eigen infrastructuur. Realtime spraak sturen we niet via externe algemene LLM's. Het latentiebudget sluit ze uit, en de dataresidentie sluit ze uit voor de gereguleerde klanten die daar echt waarde aan hechten.

Wat we publiceren over spraakkwaliteit: /benchmark draait de productiespraakpipeline maandelijks tegen FLORES-200-zinnen, voor elk gepubliceerd taalpaar. De beoordelaar is bij naam genoemd (Gemini 3.7 Flash als primaire, Claude Sonnet 5 als reserve). De volledige verdeling — mediaan, p10, p90, minimum, maximum, steekproefgrootte — staat op de pagina. In de methodologie lees je wat die cijfers wel en niet meten.


Pipeline 2: Realtime chatvertaling

Het probleem: Elk chatbericht in de meeting wordt bij verzending voor elke deelnemer vertaald in zijn eigen taal. Daarbij horen ook bewerkingen, en bewerkingen moeten eruitzien als bewerkingen, niet als nieuwe vertalingen.

Het budget: ruimer dan bij spraak. Een chatbericht mag even op zich laten wachten in een andere taal zonder dat iemand het erg vindt. Waar mensen wel om geven, is of de vertaling klopt en of bewerkingen logisch zijn.

Wat de chatpipeline werkelijk doet

Elk bericht gaat door dezelfde vertaalengine als de spraakpipeline, maar met andere voor- en nabewerking:

  • HTML-structuur blijft behouden. Chat ondersteunt opgemaakte tekst (alinea's, lijsten, citaten, vet, cursief). We zetten om naar platte tekst voor het model, vertalen en verpakken het resultaat daarna weer in de oorspronkelijke tags. Het model ziet de HTML nooit, alleen schone tekst.
  • Citaten worden onafhankelijk vertaald. Als je op een bericht reageert en het citeert, worden het [QUOTE]…[/QUOTE]-blok en de nieuwe inhoud als aparte eenheden vertaald, zodat het model de twee niet door elkaar haalt.
  • Lange berichten worden in stukken gesplitst. We splitsen op alinea-grenzen bij 1.000 tekens per stuk. Elk stuk is een eigen vertaalaanroep. We voeren geen romans van 4.000 tekens in één keer aan het model. De faalwijzen (afkappen, verloren alinea's, zinnen die midden in de zin ophouden) zijn te lelijk.
  • Vertalen gebeurt lui (lazy). We gebruiken een IntersectionObserver: een bericht wordt pas vertaald wanneer het in beeld scrolt in de viewport van de kijker. Wie in een langlopend kanaal van taal wisselde, zette vroeger elke vertaal-API-aanroep uit de geschiedenis opnieuw in gang. Nu niet meer.

Het interessante deel: bewerkingen als diffs

In v1.2 hebben we veranderd hoe chatbewerkingen zich gedragen voor kijkers in een andere taal. Vroeger werkte het zo: iemand bewerkt een bericht, wij vertalen het geheel opnieuw, jij ziet een nieuwe alinea en moet zelf zoeken wat er is verschoven.

Het nieuwe gedrag:

  1. Het oorspronkelijke bericht was al in jouw taal vertaald.
  2. Wanneer de afzender bewerkt, vertalen we de nieuwe versie opnieuw.
  3. We berekenen de diff tussen jouw vorige vertaling en jouw nieuwe vertaling, in jouw taal.
  4. We tonen die diff inline, zoals Git je laat zien wat er is veranderd.

Als dus "review by Tuesday" in het Engels "review by Thursday" wordt, ziet je Spaanstalige collega martes → jueves gemarkeerd, in plaats van een opnieuw vertaalde alinea die hij opnieuw moet lezen.

Hiervoor moesten we de chatpipeline behandelen als een stateful cache per kijker, niet als een stateless vertaal-op-aanvraag-endpoint. Documenten en spraak hebben dit niet nodig. Chat wel.


Pipeline 3: Realtime vertaling van gedeelde notities

Het probleem: De host opent een paneel met gedeelde notities en begint te typen. Elke deelnemer ziet de notities in zijn eigen taal, teken voor teken, met de structuur van het document — koppen, geneste lijsten, checklists, codeblokken — intact.

Het budget: Hetzelfde als bij chat, maar met twee extra beperkingen:

  • Wat wordt vertaald, verandert tijdens het vertalen. De host is nog aan het typen. Een naïef systeem dat bij elke toetsaanslag "het hele document" vertaalt, veroorzaakt geflikker en verbrandt het API-budget. Wij vertalen op het niveau van de gewijzigde eenheid, niet van het hele document.
  • De structuur moet behouden blijven. Als je een vertaalmodel een markdown-blok met drie geneste lijsten laat vertalen, krijg je iets terug dat eruitziet als het origineel, maar met een subtiel platgeslagen hiërarchie, hernummerde items of verschoven inspringing. Wij laten het model niet het hele blok zien.

Hoe de notitiepipeline verschilt van chat

Het behoud van structuur is het belangrijkste. We vertalen elk lijstitem afzonderlijk in plaats van als één document. Het model ziet:

"Compliance review — Q2 deliverables"

— niet:

"# Project plan\n## Quarter\n- Compliance review — Q2 deliverables\n- Vendor scoring\n - Tier 1 vendors..."

Het omringende document — de <ul>, de koppen, de inspringing — wordt aan de clientzijde opnieuw opgebouwd met dezelfde structuur als het oorspronkelijke document, waarbij elk eindknooppunt is vervangen door zijn vertaling. Het model krijgt nooit de kans de hiërarchie te "verbeteren".

Notities gebruiken ook hetzelfde diff-model per kijker als chatbewerkingen: als de host een regel wijzigt, zien kijkers in andere talen de gewijzigde woorden gemarkeerd, niet een verse alinea.


Pipeline 4: Asynchrone documentvertaling

Het probleem: Iemand zet een pdf van 40 pagina's, een Word-document, een PowerPoint-presentatie of een Excel-blad in de chat. Elke deelnemer kan een kopie in zijn eigen taal aanvragen. Het vertaalde bestand moet eruitzien als het origineel: dezelfde lettertypen, dezelfde tabellen, dezelfde paginanummers, dezelfde kop- en voetteksten, dezelfde grafieken op hun plek.

Het budget: Geen realtime-eis. Een minuut is prima. Twee minuten is ook prima. De eis is getrouwheid: als de vertaalde pdf er niet uitziet als het origineel, vertrouwt de ontvanger hem niet.

Waarom deze pipeline geen engine deelt met spraak

Een algemeen LLM, hoe goed ook, geeft je een vertaalde tekst van een document terug. Het geeft je geen vertaalde pdf met dezelfde opmaak. Het model heeft geen begrip van een "pagina-einde dat moet aansluiten op de bron" of een "tabelcel die zijn kolombreedte moet behouden".

Voor dit onderdeel gebruiken we rechtstreeks de DeepL Document API. Die is speciaal gebouwd om bestanden als bestanden te vertalen, niet tekst die uit bestanden is gehaald. DeepL verwerkt:

  • PDF (met behoud van opmaak)
  • DOCX, DOC
  • PPTX
  • XLSX

Het document wordt geüpload naar de pipeline van DeepL, aan de serverzijde vertaald met behoud van opmaak en in hetzelfde formaat teruggegeven. Het resultaat uploaden we vervolgens naar onze objectopslag en tonen we in de chat als downloadbare bijlage.

Wat dit kost en waarom we dat niet verbergen

DeepL rekent een minimum van 50.000 tekens per document, grofweg één Amerikaanse dollar per bestand op het Pro-abonnement, ongeacht of het document één pagina telt of dertig. Wij nemen die kosten voor onze rekening in plaats van per bestand door te berekenen. Ze verschijnen in het vertaalgebruik van de meeting als gefactureerde tekens, omgerekend naar woordeenheden die aansluiten bij hoe de rest van het product vertaalactiviteit rapporteert.

We kozen voor DeepL voor dit onderdeel omdat het vertalen van bestanden als bestanden precies is waarvoor het gebouwd is. We hebben niet geprobeerd een betere te bouwen. Omgekeerd geldt dat niet: DeepL draait geen live-spraakpipeline van het soort dat wij voor meetings bouwden. Andere problemen, andere gereedschappen. De eerlijke versie van "wat drijft de vertaling van InterMIND aan" is "de juiste engine per pipeline", niet "onze engine, overal".

Talen die deze pipeline dekt en spraak niet

De documentpipeline bereikt 30 talen, tegenover 23 voor spraak. Tot de extra talen behoren: Bulgaars, Grieks, Estisch, Indonesisch, Litouws, Lets, Slowaaks en Sloveens. (Arabisch staat ook op deze lijst en is een van de extra talen: het is teruggetrokken uit de realtime-kiezer zolang de spraakkwaliteit onder onze drempel ligt. De scores per taalpaar blijven openbaar op /benchmark, en dat getal brengt het terug. Voor Hindi loopt de asymmetrie andersom: live bij spraak, nog niet bij bestanden.)

Die asymmetrie is echt. Ze betekent dat een Franse deelnemer in een meeting het contract als pdf in het Estisch kan aanvragen, ook al kan hij de meeting niet in het Estisch beluisteren. We geven dat aan in de kiezer in plaats van het glad te strijken met één enkel getal. De redenering staat in het artikel over het aantal talen.


Waar de pipelines elkaar ontmoeten

De vier pipelines draaien niet geïsoleerd. Een meetingruimte is waar ze elkaar raken, en de naden doen ertoe:

  • Een chatbericht met een documentbijlage activeert de chatpipeline voor de tekst en de documentpipeline voor het bestand. De deelnemer in een andere taal ziet het bericht direct vertaald en de vertaling van de bijlage asynchroon binnenkomen als download.
  • Een gedeelde notitie die een transcriptregel citeert kruist notities ↔ spraak. Het transcript is wat de spraakpipeline produceerde voor de taal van de afzender. De notitievertaling maakt een kopie van dat citaat per kijker in ieders andere taal, met behoud van de bronvermelding.
  • Een transcript dat na de meeting wordt geëxporteerd laat de tekstpipeline in chatstijl over het volledige gesprek lopen en levert een bestand per taal op dat deelnemers kunnen downloaden. Dit is hetzelfde codepad als chatvertaling, alleen in batches.

De taalkiezer is één stuk UI. De infrastructuur eronder bestaat uit vier pipelines die met elkaar praten.


Wat we bewust niet proberen

  • Geen "uniform vertaalmodel". We bouwen niet één model dat spraak, chat, notities en documenten doet. De afweging tussen latentie en getrouwheid kent geen winnaar. We gebruiken de juiste engine per onderdeel.
  • Geen stille omleiding. Als de bestandspipeline vandaag niet naar het Hindi kan vertalen, vallen we niet stilletjes terug op de spraakengine en doen we alsof het gelukt is. De bestandskiezer geeft de leemte aan in plaats van haar te verbergen.
  • Geen "we vertalen naar 200 talen". Onze engine levert 24 talen. De live onderdelen bieden er 23, documenten 30. In plaats van één marketingvriendelijk getal publiceren we op /benchmark de kwaliteit per taalpaar die tegenover een auditor overeind moet blijven, zwakkere paren inbegrepen.

Probeer het zelf

  • Probeer de livedemo — draait de live spraakpipeline op jouw audio, in elk van de 23 producttalen. Dezelfde pipeline die de scores van /benchmark bepaalt.
  • Bekijk de benchmark — kwaliteit per taalpaar en per maand op echt verkeer. Elk paar in de kiezer, sterk of zwak, met een directe link.
  • Lees de methodologie — wat de cijfers zijn, wat ze niet zijn en wie de beoordelaar is.

Vier pipelines, vier engines, één meetingruimte. Dat is de eerlijke vervanging van de oude how-it-works-pagina.

— Het Mind.com-team


Bronnen: DeepL — ondersteunde talen, DeepL — gebruikstelling en facturering (het minimum van 50.000 tekens per bestand), FLORES-200; interne pipelinegegevens gecontroleerd aan de hand van de uitgeleverde code, gecontroleerd in augustus 2026.

Meer in Live vertaling

Alle berichten in Live vertaling
Engels is voor het eerste contact. De deal verloopt in de taal van de partner
Live vertaling

Engels is voor het eerste contact. De deal verloopt in de taal van de partner

Waar het Engels ophoudt in een exportdeal, fase voor fase: de aanvraag, de offerte, de onderhandeling, de claim, de volgende bestelling. Wat de exportafdeling vandaag betaalt voor de taal van de partner, met prijzen en bronnen, en wat er daarna bij de deal blijft.

The Mind.com Team

Turkse stemvertaler: het werkwoord komt als laatste, en dat bepaalt welke je nodig hebt
Live vertaling

Turkse stemvertaler: het werkwoord komt als laatste, en dat bepaalt welke je nodig hebt

In het Turks staat het werkwoord, en ook de ontkenning en de tijd, aan het einde van de zin. Dat ene feit maakt het verschil tussen de drie producten die als 'stemvertaler' worden verkocht: apps voor je telefoon, vertaaloordopjes en live vertalen in meetings. Wat elk daarvan wel en niet kan met een Turkse zin, en waarom het aantal talen dat een aanbieder noemt niets zegt over dit taalpaar.

The Mind.com Team

Simultaantolk: mens, RSI-platform of AI — wat jouw meertalige meeting nodig heeft (2026)
Live vertaling

Simultaantolk: mens, RSI-platform of AI — wat jouw meertalige meeting nodig heeft (2026)

"Simultaantolk" is een beroep; wat de meeste zoekopdrachten eigenlijk willen, is spraak die in een andere taal binnenkomt terwijl er gesproken wordt. Deze gids maakt onderscheid tussen de tolkencabine, het RSI-platform en AI-simultaanvertaling, vergelijkt de tools op basis van hun documentatie — Interprefy, KUDO, Wordly, DeepL Voice, Zoom, Teams, Google Meet, InterMIND — en stelt de vraag die de vergelijkingen overslaan: hoeveel van de meeting komt er daadwerkelijk terug in jouw taal, en waar draaien de gegevens.

The Mind.com Team

Ontvang nieuwe berichten en productupdates via e-mail

Eén e-mail per maand met nieuwe berichten en productupdates. U kunt zich op elk moment afmelden.