Au cœur des quatre pipelines de traduction qui font fonctionner InterMIND

Il n'existe pas « une » traduction dans InterMIND. Il existe quatre pipelines — voix, chat, notes, documents — chacun avec son propre moteur, son budget de latence et son niveau de qualité. Voici ce qui se passe réellement entre le moment où vous parlez et celui où un participant parlant une autre langue vous comprend.

The Mind.com Team

Au cœur des quatre pipelines de traduction qui font fonctionner InterMIND

Dans les coulisses des quatre pipelines de traduction qui font tourner InterMIND

L'ancienne page /product/overview/how-it-works du site mind.com a plusieurs versions majeures de retard. Elle décrit un unique « moteur de traduction », comme la plupart des pages d'éditeurs : une grande flèche allant de « vous parlez » à « ils entendent ». Cette image était déjà une simplification il y a deux ans. Aujourd'hui, elle est fausse.

En réalité, InterMIND exécute quatre pipelines de traduction distincts. Chacun résout un problème différent, avec un moteur différent, un budget de latence différent et une enveloppe de qualité différente. Ils partagent un sélecteur de langue. Ils ne partagent pas de moteur.

Voici la réponse actualisée à la question « comment ça fonctionne ? ».

Un article complémentaire : « Combien de langues prenez-vous en charge ? » présente ce que chaque pipeline couvre (23 / 23 / 30 / 17). Le présent article explique ce que chaque pipeline fait, et pourquoi il constitue un ensemble à part.


Pourquoi « un seul moteur pour tout » est un leurre

Une plateforme de réunion en direct a au moins quatre tâches à accomplir simultanément, et elles tirent dans des directions incompatibles :

  1. Voix en temps réel : l'audio entre, l'audio traduit sort pendant que l'orateur parle encore, et chaque participant l'entend dans sa propre langue. La contrainte principale est la latence.
  2. Texte du chat en temps réel : des messages courts et rapides, avec modifications, citations et structure HTML préservées.
  3. Notes partagées en temps réel : une saisie collaborative caractère par caractère, avec une hiérarchie (listes, titres, cases à cocher) qui doit survivre à la traduction.
  4. Fichiers de documents asynchrones : un PDF de 40 pages déposé dans le chat. Aucun budget de latence. La contrainte principale est la fidélité : mise en forme, tableaux, numéros de page, police.

On peut construire un seul appel LLM géant qui tente de faire les quatre. Nous l'avons essayé. Il est mauvais dans les quatre cas. Le budget de latence de la voix impose que le modèle ne réfléchisse pas ; le budget de fidélité des documents exige qu'il le fasse. Une modification dans le chat demande un diff dans la langue du lecteur ; un PDF de 40 pages exige une préservation du format qu'aucun modèle en streaming de tokens ne sait offrir.

Nous en exécutons donc quatre. Voici chacun d'eux.

Pipeline 1 : traduction vocale en temps réel

Le problème : un participant parle français. Un autre a rejoint la réunion en allemand, un troisième en portugais brésilien, un quatrième en japonais. Chacun doit entendre l'orateur dans sa propre langue, dans son propre casque, avec un délai assez court pour que le contact visuel reste possible.

Le budget : l'auditeur ne doit jamais avoir à attendre. Dès que la parole traduite accuse assez de retard pour que les gens se mettent à parler par-dessus, la réunion glisse vers « passons plutôt à l'anglais ».

Comment l'audio circule réellement

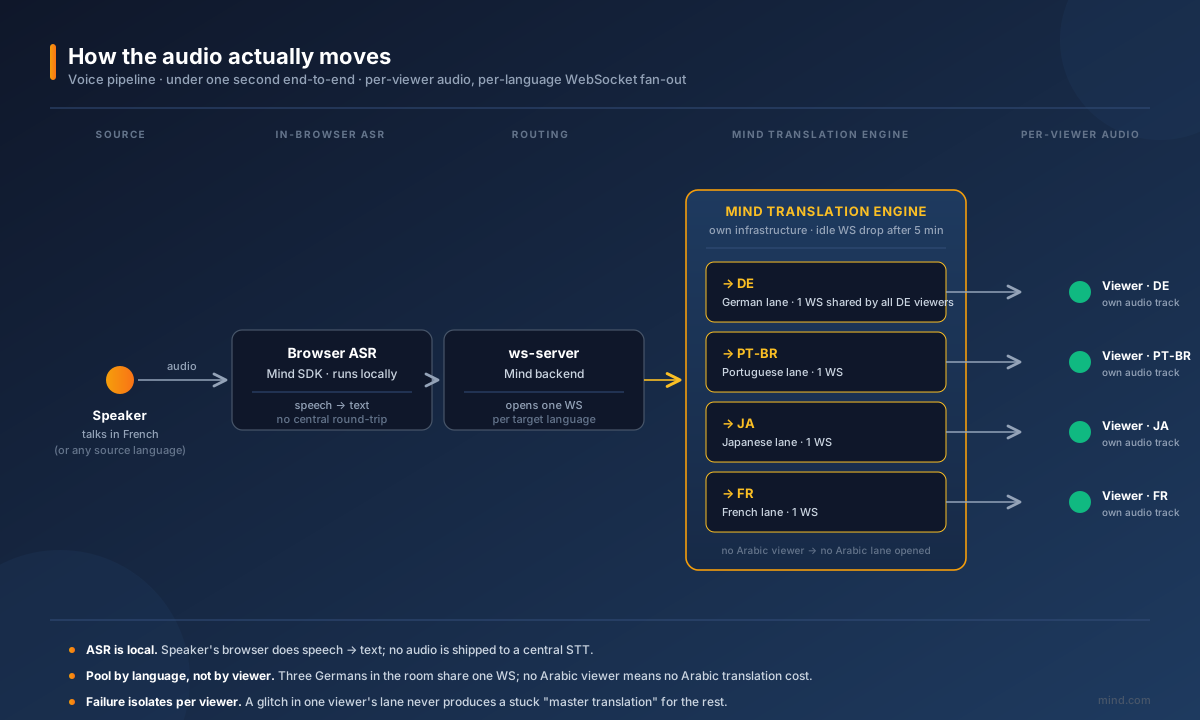
Pipeline de traduction vocale : le navigateur de l'orateur envoie l'audio via WebRTC à notre propre moteur — le serveur multimédia Mind API chez OVH, en France — qui exécute l'ASR et traduit vers chaque langue cible présente dans la salle ; chaque participant reçoit sa propre piste audio traduite, et le ws-server reçoit les mots de la transcription pour le compte rendu.

Quelques points méritent d'être explicités :

  • L'ASR s'exécute sur le serveur multimédia. L'audio de l'orateur transite par WebRTC jusqu'à notre propre moteur, Mind API chez OVH, en France, et y est reconnu, sur le serveur même qui porte l'appel ; le navigateur se contente d'envoyer l'audio et de recevoir les mots en retour. Aucun fournisseur de reconnaissance vocale distinct et aucun saut supplémentaire avant le début de la traduction. (Les messages vocaux du chat font exception : leur transcription s'exécute sur Azure AI Speech, le service vocal de la passerelle IA par défaut.)
  • La traduction n'est pas une diffusion unique à tous. Le moteur traduit par langue cible présente dans la salle, et non par participant : la traduction vers une langue démarre quand le premier auditeur de cette langue demande un flux traduit, trois participants ayant choisi l'allemand partagent une seule traduction allemande, et si personne n'écoute en arabe, rien n'est traduit vers l'arabe. C'est pourquoi une réunion en quatre langues coûte le même prix qu'une réunion en quarante langues, au nombre de langues réellement présentes près : nous ne traduisons jamais vers des langues dans lesquelles aucun participant n'écoute.
  • La parole synthétisée est propre à chaque participant. Chacun reçoit sa propre piste audio traduite, mixée avec la vidéo de l'orateur d'origine. Les participants ne regardent pas une « réunion traduite » unique : ils regardent la même réunion, avec leur canal audio personnel traduit dans la langue choisie. C'est pourquoi deux personnes présentes dans la même pièce peuvent chacune brancher un casque et entendre des langues différentes.

Pourquoi cela compte quand une réunion tourne mal

Dans un appel de 60 minutes avec huit langues, les choses se dérèglent de manières intéressantes : des WebSockets se coupent, l'ASR transcrit temporairement mal un nom propre, le réseau d'un participant devient instable. L'architecture décrite ci-dessus nous permet d'isoler les pannes : le son d'un participant qui saute n'affecte pas les sept autres, car le moteur de traduction n'a jamais produit « la traduction » : il en a produit huit, en parallèle, et seule celle qui est touchée doit se rétablir.

Le moteur est le nôtre, hébergé sur notre propre infrastructure. Nous ne faisons pas passer la voix en temps réel par des LLM généralistes tiers. Le budget de latence les exclut ; la résidence des données les exclut aussi pour les clients soumis à une réglementation, qui y sont les plus attentifs.

Ce que nous publions sur la qualité vocale : /benchmark fait passer chaque mois le pipeline vocal de production sur des phrases FLORES-200, pour chaque paire de langues publiée. Le juge est nommé (Gemini 3.7 Flash en principal, Claude Sonnet 5 en secours). La distribution complète — médiane, p10, p90, minimum, maximum, taille de l'échantillon — figure sur la page. Consultez la méthodologie pour savoir ce que ces chiffres mesurent et ce qu'ils ne mesurent pas.


Pipeline 2 : traduction du chat en temps réel

Le problème : chaque message du chat de la réunion, traduit pour chaque participant dans sa propre langue, au moment de l'envoi. Et les modifications aussi, qui doivent ressembler à des modifications, pas à des retraductions.

Le budget : plus souple que pour la voix. Un message de chat peut mettre un instant à apparaître dans une autre langue sans que personne s'en soucie. Ce qui compte, c'est que la traduction soit juste et que les modifications aient du sens.

Ce que fait réellement le pipeline du chat

Chaque message passe par le même moteur de traduction que le pipeline vocal, mais avec un pré-traitement et un post-traitement différents :

  • La structure HTML est préservée. Le chat prend en charge le texte enrichi (paragraphes, listes, citations, gras, italique). Nous le convertissons en texte brut pour le modèle, traduisons, puis réencapsulons le résultat dans les balises d'origine. Le modèle ne voit jamais le HTML : il voit une prose propre.
  • Les citations sont traduites indépendamment. Si vous répondez à un message en le citant, le bloc [QUOTE]…[/QUOTE] et le nouveau contenu sont traduits comme des unités distinctes, afin que le modèle ne puisse pas les confondre.
  • Les messages longs sont découpés. Nous coupons aux limites de paragraphes, par blocs de 1 000 caractères. Chaque bloc fait l'objet d'un appel de traduction distinct. Nous ne soumettons pas au modèle des romans de 4 000 caractères d'un seul tenant : les modes de défaillance (troncature, paragraphes perdus, coupures en milieu de phrase) sont trop disgracieux.
  • La traduction est paresseuse. Nous utilisons un IntersectionObserver : un message n'est traduit que lorsqu'il entre dans la zone visible du lecteur. Changer de langue dans un canal actif depuis longtemps rejouait auparavant tous les appels d'API de traduction de l'historique. Ce n'est plus le cas.

La partie intéressante : les modifications sous forme de diffs

Dans la v1.2, nous avons changé le comportement des modifications du chat pour les lecteurs dans une autre langue. Auparavant, quand quelqu'un modifiait un message, nous retraduisions l'ensemble, et vous voyiez un paragraphe tout neuf dont il fallait repérer ce qui avait changé.

Le nouveau comportement :

  1. Le message d'origine était déjà traduit dans votre langue.
  2. Quand l'expéditeur le modifie, nous retraduisons la nouvelle version.
  3. Nous calculons le diff entre votre traduction précédente et votre nouvelle traduction, dans votre langue.
  4. Nous affichons ce diff en ligne, à la manière de Git qui vous montre ce qui a changé.

Ainsi, quand « review by Tuesday » devient « review by Thursday » en anglais, votre collègue hispanophone voit martes → jueves en surbrillance, et non un paragraphe retraduit qu'il doit relire en entier.

Cela a exigé de traiter le pipeline du chat comme un cache avec état par lecteur, et non comme un point d'accès sans état qui traduit à la demande. Les documents et la voix n'en ont pas besoin. Le chat, si.


Pipeline 3 : traduction des notes partagées en temps réel

Le problème : l'hôte ouvre un volet de notes partagées et commence à écrire. Chaque participant voit les notes dans sa langue, caractère par caractère, avec la structure du document (titres, listes imbriquées, listes de tâches, blocs de code) intacte.

Le budget : le même que pour le chat, avec deux contraintes supplémentaires :

  • Ce qui est traduit change en cours de traduction. L'hôte est encore en train d'écrire. Un système naïf qui traduit « tout le document » à chaque frappe produit du scintillement et épuise le budget d'API. Nous traduisons à la granularité de l'unité modifiée, pas du document entier.
  • La structure doit survivre. Si vous demandez à un modèle de traduction de traduire un bloc markdown contenant trois listes imbriquées, vous obtenez quelque chose qui ressemble à l'original, mais dont la hiérarchie est subtilement aplatie, dont les éléments sont renumérotés ou dont l'indentation a bougé. Nous ne laissons pas le modèle voir le bloc entier.

En quoi le pipeline des notes diffère de celui du chat

La préservation de la structure est l'essentiel. Nous traduisons chaque élément de liste indépendamment, plutôt que le document d'un seul bloc. Le modèle voit :

« Revue de conformité — livrables du T2 »

et non :

« # Plan de projet\n## Trimestre\n- Revue de conformité — livrables du T2\n- Évaluation des fournisseurs\n - Fournisseurs de niveau 1... »

Le document englobant (le <ul>, les titres, l'indentation) est reconstruit côté client avec la même structure que le document d'origine, chaque nœud terminal étant remplacé par sa traduction. Le modèle n'a jamais l'occasion d'« améliorer » la hiérarchie.

Les notes utilisent aussi le même modèle de diff par lecteur que les modifications du chat : si l'hôte change une ligne, les lecteurs dans d'autres langues voient les mots modifiés en surbrillance, et non un paragraphe tout neuf.


Pipeline 4 : traduction asynchrone de documents

Le problème : quelqu'un dépose dans le chat un PDF de 40 pages, un document Word, une présentation PowerPoint ou une feuille Excel. Chaque participant peut en demander une copie dans sa propre langue. Le fichier traduit doit ressembler à l'original : mêmes polices, mêmes tableaux, mêmes numéros de page, mêmes en-têtes, mêmes graphiques au même endroit.

Le budget : aucune contrainte de temps réel. Une minute, ça va. Deux minutes, ça va aussi. La contrainte est la fidélité : si le PDF traduit ne ressemble pas à l'original, le destinataire ne lui fera pas confiance.

Pourquoi ce pipeline ne partage pas de moteur avec la voix

Un LLM généraliste, même très bon, vous rendra un texte traduit du document. Il ne vous rendra pas un PDF traduit avec la même mise en page. Le modèle n'a aucune notion de « saut de page qui doit s'aligner sur la source » ni de « cellule de tableau qui doit conserver la largeur de sa colonne ».

Pour cette surface, nous utilisons directement la DeepL Document API. Elle est conçue pour traduire des fichiers en tant que fichiers, et non de la prose extraite de fichiers. DeepL prend en charge :

  • PDF (avec préservation de la mise en page)
  • DOCX, DOC
  • PPTX
  • XLSX

Le document est envoyé au pipeline de DeepL, traduit côté serveur avec sa mise en forme intacte, puis renvoyé dans le même format. Nous téléversons ensuite le résultat dans notre stockage d'objets et le restituons dans le chat sous forme de pièce jointe téléchargeable.

Ce que cela coûte, et pourquoi nous ne le cachons pas

DeepL facture un minimum de 50 000 caractères par document — environ un dollar américain par fichier avec l'offre Pro, que le document fasse une page ou trente. Nous absorbons ce coût plutôt que de facturer au fichier ; il apparaît dans la consommation de traduction de la réunion sous la forme de caractères facturés, convertis en unités de mots, qui correspondent à la manière dont le reste du produit rend compte de l'activité de traduction.

Nous avons choisi DeepL pour cette surface parce que traduire des fichiers en tant que fichiers est exactement le travail pour lequel il a été conçu ; nous n'avons pas cherché à en construire un meilleur. L'inverse n'est pas vrai : DeepL n'exploite pas de pipeline de voix en direct du type de celui que nous avons construit pour les réunions. Des problèmes différents, des outils différents. La version honnête de « qu'est-ce qui propulse la traduction d'InterMIND » est « le bon moteur pour chaque pipeline », et non « notre moteur, partout ».

Les langues que ce pipeline couvre et que la voix ne couvre pas

Le pipeline de documents atteint 30 langues, contre 23 pour la voix. Les langues supplémentaires comprennent : le bulgare, le grec, l'estonien, l'indonésien, le lituanien, le letton, le slovaque et le slovène. (L'arabe figure aussi sur cette liste, et c'est l'une des langues supplémentaires : il est retiré du sélecteur en temps réel tant que sa qualité vocale est inférieure à notre seuil, et ses scores par paire restent publics sur /benchmark — c'est ce chiffre qui le fera revenir. L'asymétrie joue dans l'autre sens pour l'hindi : disponible en voix, pas encore pour les fichiers.)

Cette asymétrie est réelle. Elle signifie qu'un participant français à une réunion peut demander le PDF du contrat en estonien, même s'il ne peut pas suivre la réunion en estonien. Nous la signalons dans le sélecteur plutôt que de la lisser derrière un chiffre unique. Le raisonnement est exposé dans l'article sur le nombre de langues.


Là où les pipelines se rencontrent

Les quatre pipelines ne fonctionnent pas en vase clos. Une salle de réunion est l'endroit où ils se touchent, et les points de jonction comptent :

  • Un message de chat avec un document en pièce jointe déclenche le pipeline du chat pour le texte et le pipeline de documents pour le fichier. Le participant d'une autre langue voit le message traduit immédiatement, et la traduction de la pièce jointe arrive ensuite de manière asynchrone sous forme de fichier téléchargeable.
  • Une note partagée qui cite une ligne de transcription croise notes ↔ voix. La transcription est ce que le pipeline vocal a produit dans la langue de l'expéditeur ; la traduction de la note produit pour chaque lecteur une copie de cette citation dans la langue de tous les autres, avec son attribution d'origine préservée.
  • Une transcription exportée après la réunion fait passer l'ensemble de la conversation dans le pipeline de texte de type chat, ce qui produit un fichier par langue que les participants peuvent télécharger. C'est le même chemin de code que la traduction du chat, simplement traité par lots.

Le sélecteur de langue n'est qu'un élément d'interface. L'infrastructure en dessous, ce sont quatre pipelines qui dialoguent entre eux.


Ce que nous nous interdisons délibérément

  • Pas de « modèle de traduction unifié ». Nous ne construisons pas un modèle unique qui ferait la voix, le chat, les notes et les documents. Le compromis entre latence et fidélité n'a pas de gagnant. Nous utilisons le bon moteur pour chaque surface.
  • Pas de réacheminement silencieux. Si le pipeline de fichiers ne peut pas traduire vers l'hindi aujourd'hui, nous ne basculons pas discrètement vers le moteur vocal en faisant comme si cela avait fonctionné : le sélecteur de fichiers signale le manque au lieu de le masquer.
  • Pas de « nous traduisons vers 200 langues ». Notre moteur en produit 24. Les surfaces en direct en proposent 23, les documents 30 — et plutôt qu'un chiffre vitrine, la qualité par paire, celle qui doit tenir face à un auditeur, est publiée sur /benchmark, paires les plus faibles comprises.

Essayez par vous-même

  • Essayer la démo en direct — exécute le pipeline vocal en direct sur votre audio, dans l'une des 23 langues du produit. C'est le même pipeline que celui qui est évalué sur /benchmark.
  • Consulter le benchmark — la qualité par paire et par mois sur du trafic réel. Chaque paire du sélecteur, forte ou faible, est accessible par lien direct.
  • Lire la méthodologie — ce que sont les chiffres, ce qu'ils ne sont pas, qui est le juge.

Quatre pipelines, quatre moteurs, une seule salle de réunion. Voilà le remplaçant honnête de l'ancienne page how-it-works.

— L'équipe Mind.com


Sources : DeepL — langues prises en charge, DeepL — décompte d'utilisation et facturation (le minimum de 50 000 caractères par fichier), FLORES-200 ; les faits internes sur les pipelines ont été vérifiés par rapport au code livré, contrôle effectué en août 2026.

Plus dans Traduction en direct

Tous les articles dans Traduction en direct
Traducteur vocal turc : le verbe arrive en dernier, et c'est ce qui détermine celui dont vous avez besoin
Traduction en direct

Traducteur vocal turc : le verbe arrive en dernier, et c'est ce qui détermine celui dont vous avez besoin

En turc, le verbe — ainsi que la négation et le temps — se place à la fin de la phrase. Ce seul fait distingue les trois produits vendus comme « traducteur vocal » : les applications mobiles, les écouteurs traducteurs et la traduction en direct des réunions. Ce que chacun peut et ne peut pas faire avec une phrase turque, et pourquoi le nombre de langues annoncé par un éditeur ne dit rien de cette paire de langues.

The Mind.com Team

Interprète simultané : humain, plateforme RSI ou IA — ce dont votre réunion multilingue a besoin (2026)
Traduction en direct

Interprète simultané : humain, plateforme RSI ou IA — ce dont votre réunion multilingue a besoin (2026)

« Interprète simultané » est un métier ; ce que recherchent la plupart des internautes, c'est une parole qui arrive dans une autre langue pendant qu'elle est prononcée. Ce guide distingue la cabine, la plateforme RSI et la traduction simultanée par IA, compare les outils d'après leur documentation — Interprefy, KUDO, Wordly, DeepL Voice, Zoom, Teams, Google Meet, InterMIND — et pose les questions que les comparatifs éludent : quelle part de la réunion vous parvient réellement dans votre langue, et où transitent les données.

The Mind.com Team

Traduction simultanée : cabine, RSI ou IA — et quels outils pour vos réunions (2026)
Traduction en direct

Traduction simultanée : cabine, RSI ou IA — et quels outils pour vos réunions (2026)

« Traduction simultanée » recouvre trois réalités : l'interprète en cabine, l'interprétation à distance (RSI) et la traduction IA en temps réel. Ce guide sépare les trois, compare les outils documentés — Interprefy, KUDO, Wordly, DeepL Voice, Zoom, Teams, Google Meet, InterMIND — et pose la question que les comparatifs oublient : quelle part de la réunion revient vraiment dans votre langue ?

The Mind.com Team

Recevez les nouveaux articles et mises à jour du produit par e-mail

Un e-mail par mois avec de nouveaux articles et des mises à jour du produit. Désabonnement à tout moment.