Dentro le quattro pipeline di traduzione che fanno funzionare InterMIND

In InterMIND non esiste "la traduzione". Esistono quattro pipeline — voce, chat, note, documenti — ciascuna con il proprio motore, il proprio budget di latenza e il proprio livello di qualità. Ecco cosa succede davvero tra il momento in cui parli e il momento in cui un partecipante di un'altra lingua ti capisce.

The Mind.com Team

Dentro le quattro pipeline di traduzione che fanno funzionare InterMIND

Dentro le quattro pipeline di traduzione che fanno funzionare InterMIND

La vecchia pagina /product/overview/how-it-works su mind.com è indietro di diverse release maggiori. Descrive un unico «motore di traduzione», come fa la maggior parte delle pagine dei vendor: una grande freccia da «tu parli» a «loro ascoltano». Due anni fa quell'immagine era già una semplificazione. Oggi è sbagliata.

La verità è che InterMIND fa girare quattro pipeline di traduzione separate, ognuna delle quali risolve un problema diverso con un motore diverso, un diverso budget di latenza e un diverso livello di qualità. Condividono il selettore della lingua. Non condividono il motore.

Questa è la risposta aggiornata a «come funziona».

Un articolo complementare: "Quante lingue supportate?" spiega cosa copre ciascuna pipeline (23 / 23 / 30 / 17). Questo articolo spiega cosa fa ciascuna pipeline, e perché è una cosa a sé.


Perché «un solo motore per tutto» è una bugia

Una piattaforma per meeting dal vivo ha almeno quattro compiti da svolgere contemporaneamente, e tirano in direzioni inconciliabili:

  1. Voce in tempo reale: audio in ingresso, audio tradotto in uscita mentre chi parla sta ancora parlando, con ogni partecipante nella propria lingua. Il vincolo più duro è la latenza.
  2. Chat testuale in tempo reale: messaggi brevi e veloci, con modifiche, citazioni e struttura HTML preservate.
  3. Note condivise in tempo reale: digitazione collaborativa carattere per carattere, con una gerarchia strutturale (elenchi, titoli, caselle di controllo) che deve sopravvivere alla traduzione.
  4. File di documenti asincroni: un PDF di 40 pagine caricato in chat. Nessun budget di latenza. Il vincolo più duro è la fedeltà: formattazione, tabelle, numeri di pagina, caratteri.

Si può costruire un'unica gigantesca chiamata a un LLM che provi a fare tutte e quattro le cose. Ci abbiamo provato. Funziona male in tutte e quattro. Il budget di latenza della voce impone che il modello non possa «pensare»; il budget di fedeltà dei documenti impone che debba farlo. Una modifica in chat richiede un diff nella lingua di chi legge; un PDF di 40 pagine richiede una conservazione del formato che nessun modello a streaming di token può darti.

Quindi ne facciamo girare quattro. Ecco ciascuna.
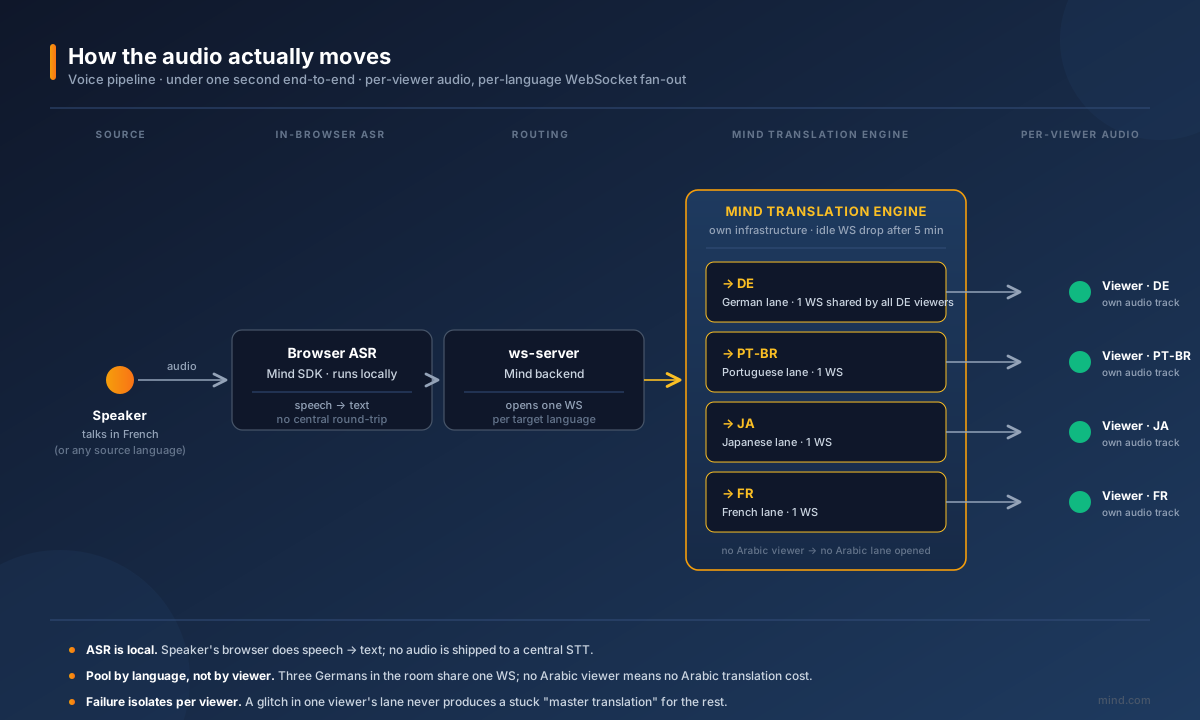

Pipeline 1: traduzione vocale in tempo reale

Il problema: un partecipante parla francese. Un altro è entrato in tedesco, un terzo in portoghese brasiliano, un quarto in giapponese. Ognuno deve sentire chi parla nella propria lingua, nel proprio orecchio, con un ritardo abbastanza breve da rendere possibile il contatto visivo.

Il budget: chi ascolta non deve mai doverlo aspettare. Quando la voce tradotta resta indietro al punto che le persone iniziano a parlarle sopra, il meeting scivola verso il «passiamo direttamente all'inglese».

Come si muove davvero l'audio

Pipeline di traduzione vocale: il browser di chi parla invia l'audio via WebRTC al nostro motore — il media server della Mind API presso OVH, Francia — che esegue l'ASR e traduce in ogni lingua di destinazione presente nella stanza; ogni partecipante riceve la propria traccia audio tradotta, e il ws-server riceve le parole della trascrizione per il recap.

Alcune cose che vale la pena dire esplicitamente:

  • L'ASR gira sul media server. L'audio di chi parla viaggia via WebRTC fino al nostro motore, la Mind API presso OVH, Francia, e viene riconosciuto lì, sullo stesso server che trasporta la chiamata; il browser si limita a inviare l'audio e a ricevere indietro le parole. Nessun fornitore di riconoscimento vocale separato e nessun passaggio aggiuntivo prima che la traduzione possa iniziare. (Le note vocali in chat sono l'eccezione: il loro speech-to-text gira su Azure AI Speech, il servizio vocale del gateway AI predefinito.)
  • La traduzione non è un'unica diffusione a ventaglio. Il motore traduce per ogni lingua di destinazione presente nella stanza, non per ogni partecipante: la traduzione in una lingua parte quando il primo ascoltatore di quella lingua richiede un flusso tradotto, tre partecipanti che hanno scelto il tedesco condividono un'unica traduzione tedesca, e se nessuno ascolta in arabo non si traduce nulla in arabo. Per questo un meeting in quattro lingue costa quanto uno in quaranta, fino al punto di chi si è effettivamente presentato: non traduciamo mai in lingue in cui nessun partecipante sta ascoltando.
  • La voce sintetizzata è per singolo partecipante. Ogni partecipante riceve la propria traccia audio tradotta, mixata con il video originale di chi parla. Non guardano un «meeting tradotto» principale: guardano lo stesso meeting, con il proprio canale audio personale tradotto nella lingua scelta. Per questo due persone nella stessa stanza fisica possono infilarsi ciascuna le proprie cuffie e sentire lingue diverse.

Perché è importante quando un meeting va storto

In una chiamata di 60 minuti con otto lingue, le cose si rompono in modi interessanti: i WebSocket cadono, l'ASR trascrive male per un momento un nome proprio, la rete di un partecipante diventa instabile. L'architettura descritta sopra è ciò che ci permette di isolare i guasti: se l'audio di un partecipante ha un problema, gli altri sette non ne risentono, perché il motore di traduzione non ha mai prodotto «la traduzione»: ne ha prodotte otto, in parallelo, e solo quella interessata deve riprendersi.

Il motore è nostro, ospitato sulla nostra infrastruttura. Non instradiamo la voce in tempo reale attraverso LLM generalisti di terze parti. Il budget di latenza li esclude; la questione della residenza dei dati li esclude per i clienti regolamentati, a cui questo importa davvero.

Cosa pubblichiamo sulla qualità vocale: /benchmark esegue ogni mese la pipeline vocale di produzione su frasi di FLORES-200 per ogni coppia di lingue pubblicata. Il giudice è dichiarato (Gemini 3.7 Flash come primario, Claude Sonnet 5 come riserva). La distribuzione completa — mediana, p10, p90, minimo, massimo, dimensione del campione — è sulla pagina. Consulta la metodologia per capire cosa misurano e cosa non misurano quei numeri.


Pipeline 2: traduzione della chat in tempo reale

Il problema: ogni messaggio della chat nel meeting, tradotto per ogni partecipante nella sua lingua, nel momento in cui viene inviato. Più le modifiche, che devono sembrare modifiche e non ritraduzioni.

Il budget: più ampio di quello della voce. Un messaggio in chat può impiegare un attimo ad apparire in un'altra lingua senza che a nessuno importi. Ciò che interessa alle persone è che la traduzione sia giusta e che le modifiche abbiano senso.

Cosa fa davvero la pipeline della chat

Ogni messaggio passa attraverso lo stesso motore di traduzione usato dalla pipeline vocale, ma con pre- e post-elaborazione diverse:

  • La struttura HTML viene preservata. La chat supporta il rich text (paragrafi, elenchi, citazioni, grassetto, corsivo). Convertiamo in testo semplice per il modello, traduciamo, poi riavvolgiamo il risultato nei tag originali. Il modello non vede mai l'HTML: vede prosa pulita.
  • Le citazioni vengono tradotte in modo indipendente. Se rispondi a un messaggio citandolo, il blocco [QUOTE]…[/QUOTE] e il nuovo contenuto vengono tradotti come unità separate, così il modello non può confonderli.
  • I messaggi lunghi vengono suddivisi. Dividiamo ai confini di paragrafo a 1.000 caratteri per blocco. Ogni blocco è una chiamata di traduzione a sé. Non diamo in pasto al modello romanzi da 4.000 caratteri in un colpo solo: i modi in cui fallisce (troncamenti, paragrafi persi, frasi interrotte a metà) sono troppo brutti.
  • La traduzione è pigra (lazy). Usiamo un IntersectionObserver: un messaggio viene tradotto solo quando entra nel viewport di chi legge. Cambiare lingua in un canale attivo da tempo faceva ripetere dalla cronologia ogni chiamata all'API di traduzione. Ora non più.

La parte interessante: le modifiche come diff

Nella v1.2 abbiamo cambiato il comportamento delle modifiche in chat per chi legge in un'altra lingua. Il vecchio comportamento era: qualcuno modifica un messaggio, noi ritraduciamo tutto, tu vedi un paragrafo nuovo e devi capire cosa è cambiato.

Il nuovo comportamento:

  1. Il messaggio originale era già stato tradotto nella tua lingua.
  2. Quando chi scrive lo modifica, ritraduciamo la nuova versione.
  3. Calcoliamo il diff tra la tua traduzione precedente e la tua nuova traduzione, nella tua lingua.
  4. Mostriamo quel diff direttamente nel testo, nello stesso modo in cui Git ti mostra cosa è cambiato.

Così, quando in inglese «review by Tuesday» diventa «review by Thursday», il tuo collega che legge in spagnolo vede evidenziato martes → jueves, non un paragrafo ritradotto da rileggere.

Questo ha richiesto di trattare la pipeline della chat come una cache con stato per singolo partecipante, non come un endpoint senza stato che traduce a richiesta. I documenti e la voce non ne hanno bisogno. La chat sì.


Pipeline 3: traduzione delle note condivise in tempo reale

Il problema: chi organizza apre un pannello di note condivise e inizia a scrivere. Ogni partecipante vede le note nella propria lingua, carattere per carattere, con la struttura del documento (titoli, elenchi annidati, checklist, blocchi di codice) intatta.

Il budget: lo stesso della chat, ma con due vincoli in più:

  • Ciò che viene tradotto cambia durante la traduzione. Chi organizza sta ancora scrivendo. Un sistema ingenuo che traduce «l'intero documento» a ogni battuta produce sfarfallio e brucia il budget delle API. Noi traduciamo con la granularità dell'unità modificata, non dell'intero documento.
  • La struttura deve sopravvivere. Se chiedi a un modello di traduzione di tradurre un blob markdown con tre elenchi annidati, ottieni qualcosa che sembra l'originale ma con la gerarchia leggermente appiattita, gli elementi rinumerati o i rientri spostati. Non lasciamo che il modello veda l'intero blob.

In cosa la pipeline delle note differisce dalla chat

La conservazione della struttura è la differenza principale. Traduciamo ogni elemento di elenco in modo indipendente invece che come un unico documento. Il modello vede:

"Revisione di compliance — Consegne del Q2"

— e non:

"# Piano di progetto\n## Trimestre\n- Revisione di compliance — Consegne del Q2\n- Valutazione dei fornitori\n - Fornitori Tier 1..."

Il documento che fa da involucro (il <ul>, i titoli, i rientri) viene ricostruito lato client usando la stessa struttura del documento originale, con ogni nodo foglia sostituito dalla sua traduzione. Il modello non ha mai occasione di «migliorare» la gerarchia.

Anche le note usano lo stesso modello di diff per singolo partecipante delle modifiche in chat: se chi organizza cambia una riga, chi legge in altre lingue vede evidenziate le parole cambiate, non un paragrafo nuovo.


Pipeline 4: traduzione asincrona dei documenti

Il problema: qualcuno carica in chat un PDF di 40 pagine, un documento Word, una presentazione PowerPoint o un foglio Excel. Ogni partecipante può richiederne una copia nella propria lingua. Il file tradotto deve assomigliare all'originale: stessi caratteri, stesse tabelle, stessi numeri di pagina, stesse intestazioni, stessi grafici al loro posto.

Il budget: nessun vincolo di tempo reale. Un minuto va bene. Due minuti vanno bene. Il vincolo è la fedeltà: se il PDF tradotto non assomiglia all'originale, chi lo riceve non si fiderà.

Perché questa pipeline non condivide il motore con la voce

Un LLM generalista, anche molto buono, ti restituirà un testo tradotto di un documento. Non ti restituirà un PDF tradotto con lo stesso layout. Il modello non ha il concetto di «interruzione di pagina che deve combaciare con l'originale» o di «cella di tabella che deve mantenere la larghezza della colonna».

Per questa superficie usiamo direttamente la DeepL Document API. È costruita apposta per tradurre file come file, non prosa estratta dai file. DeepL gestisce:

  • PDF (con conservazione del layout)
  • DOCX, DOC
  • PPTX
  • XLSX

Il documento viene caricato nella pipeline di DeepL, tradotto lato server con la formattazione intatta e restituito nello stesso formato. Poi carichiamo il risultato nel nostro object storage e lo rendiamo disponibile in chat come allegato scaricabile.

Quanto costa e perché non lo nascondiamo

DeepL fattura un minimo di 50.000 caratteri per documento, circa un dollaro statunitense a file sul piano Pro, indipendentemente dal fatto che il documento sia di una pagina o di trenta. Ci facciamo carico di quel costo invece di addebitarlo per file; compare nell'utilizzo di traduzione del meeting come caratteri fatturati, convertiti in unità-parola in linea con il modo in cui il resto del prodotto riporta l'attività di traduzione.

Abbiamo scelto DeepL per questa superficie perché tradurre file come file è esattamente il lavoro per cui è stato costruito: non abbiamo provato a costruirne uno migliore. Non vale il contrario: DeepL non gestisce una pipeline vocale dal vivo del tipo che abbiamo costruito per i meeting. Problemi diversi, strumenti diversi. La versione onesta di «cosa alimenta la traduzione di InterMIND» è «il motore giusto per ogni pipeline», non «il nostro motore, ovunque».

Le lingue che questa pipeline copre e la voce no

La pipeline dei documenti arriva a 30 lingue, contro le 23 della voce. Tra le aggiuntive: bulgaro, greco, estone, indonesiano, lituano, lettone, slovacco, sloveno. (Anche l'arabo è in questo elenco ed è una delle lingue aggiuntive: è stato ritirato dal selettore in tempo reale finché la sua qualità vocale è sotto il nostro livello, e i punteggi per coppia restano pubblici su /benchmark: è quel dato a riportarlo. L'asimmetria va nell'altra direzione per l'hindi: attivo sulla voce, non ancora sui file.)

Quell'asimmetria è reale. Significa che un partecipante francese in un meeting può richiedere il PDF del contratto in estone anche se non può ascoltare il meeting in estone. Lo segnaliamo nel selettore invece di appianarlo con un unico numero. Il ragionamento è nell'articolo sul numero di lingue.


Dove le pipeline si incontrano

Le quattro pipeline non girano in isolamento. Una stanza di meeting è il luogo in cui si toccano, e le giunture contano:

  • Un messaggio in chat con un documento allegato attiva la pipeline della chat per il testo e quella dei documenti per il file. Il partecipante in un'altra lingua vede subito il messaggio tradotto e la traduzione dell'allegato che arriva in modo asincrono come file scaricabile.
  • Una nota condivisa che cita una riga della trascrizione attraversa note ↔ voce. La trascrizione è ciò che la pipeline vocale ha prodotto per la lingua di chi ha parlato; la traduzione della nota produce una copia della citazione per ogni partecipante nella lingua di tutti gli altri, con l'attribuzione della fonte preservata.
  • Una trascrizione esportata dopo il meeting fa girare la pipeline di testo in stile chat sull'intera conversazione, producendo un file per lingua che i partecipanti possono scaricare. È lo stesso percorso di codice della traduzione della chat, solo in batch.

Il selettore della lingua è un unico elemento dell'interfaccia. L'infrastruttura sotto sono quattro pipeline che si parlano tra loro.


Cosa non proviamo deliberatamente a fare

  • Nessun «modello di traduzione unificato». Non stiamo costruendo un modello unico che faccia voce, chat, note e documenti. Il compromesso tra latenza e fedeltà non ha un vincitore. Usiamo il motore giusto per ogni superficie.
  • Nessun re-instradamento silenzioso. Se oggi la pipeline dei file non può tradurre in hindi, non ripieghiamo di nascosto sul motore vocale facendo finta che abbia funzionato: il selettore dei file segnala il vuoto invece di nasconderlo.
  • Nessun «traduciamo in 200 lingue». Il nostro motore ne emette 24. Le superfici dal vivo ne offrono 23, i documenti 30 — e invece di un unico numero da marketing, la qualità per singola coppia, quella che deve reggere davanti a un revisore, è pubblicata su /benchmark, comprese le coppie più deboli.

Provalo tu stesso

  • Prova la demo dal vivo: esegue la pipeline vocale dal vivo sul tuo audio, in una qualsiasi delle 23 lingue del prodotto. La stessa pipeline che produce i punteggi di /benchmark.
  • Guarda il benchmark: qualità per coppia e per mese su traffico reale. Ogni coppia del selettore, forte o debole, raggiungibile con un link diretto.
  • Leggi la metodologia: cosa sono i numeri, cosa non sono, chi è il giudice.

Quattro pipeline, quattro motori, una sola stanza di meeting. Questa è la sostituzione onesta della vecchia pagina how-it-works.

— Il team di Mind.com


Fonti: DeepL — lingue supportate, DeepL — conteggio dell'utilizzo e fatturazione (il minimo di 50.000 caratteri per file), FLORES-200; i fatti interni sulle pipeline sono verificati sul codice rilasciato, controllati ad agosto 2026.

Altro in Traduzione in tempo reale

Tutti i post in Traduzione in tempo reale
L'inglese basta per il primo contatto. La trattativa va nella lingua del partner
Traduzione in tempo reale

L'inglese basta per il primo contatto. La trattativa va nella lingua del partner

Dove finisce l'inglese in una trattativa export, passaggio per passaggio: la richiesta, l'offerta, la trattativa, il reclamo, il riordino. Cosa paga oggi l'ufficio estero per la lingua del partner, con prezzi e fonti, e cosa resta della trattativa dopo.

The Mind.com Team

Traduttore vocale turco: il verbo arriva per ultimo, ed è questo a decidere quale ti serve
Traduzione in tempo reale

Traduttore vocale turco: il verbo arriva per ultimo, ed è questo a decidere quale ti serve

Il turco mette il verbo — e la negazione, e il tempo verbale — alla fine della frase. Questo singolo fatto distingue i tre prodotti venduti come "traduttore vocale": le app per smartphone, gli auricolari traduttori e la traduzione dal vivo nei meeting. Cosa può e cosa non può fare ciascuno con una frase in turco, e perché il numero di lingue dichiarato da un fornitore non dice nulla su questa coppia.

The Mind.com Team

Interprete simultaneo: umano, piattaforma RSI o AI — di cosa ha bisogno la tua riunione multilingue (2026)
Traduzione in tempo reale

Interprete simultaneo: umano, piattaforma RSI o AI — di cosa ha bisogno la tua riunione multilingue (2026)

"Interprete simultaneo" è una professione; ciò che la maggior parte delle ricerche cerca davvero è un discorso che arriva in un'altra lingua mentre viene pronunciato. Questa guida distingue la cabina, la piattaforma RSI e la traduzione simultanea con AI, confronta gli strumenti in base alla loro documentazione — Interprefy, KUDO, Wordly, DeepL Voice, Zoom, Teams, Google Meet, InterMIND — e si chiede ciò che i confronti trascurano: quanta parte della riunione ti torna davvero nella tua lingua e dove vengono elaborati i dati.

The Mind.com Team

Ricevi nuovi post e aggiornamenti del prodotto via email

Un'email al mese con nuovi post e aggiornamenti sul prodotto. Disiscriviti in qualsiasi momento.