Усередині чотирьох конвеєрів перекладу, на яких працює InterMIND

В InterMIND немає єдиного «перекладу». Є чотири конвеєри — голос, чат, нотатки, документи — і кожен має власний рушій, ліміт затримки та межі якості. Ось що насправді відбувається між моментом, коли ви говорите, і моментом, коли учасник іншою мовою вас розуміє.

The Mind.com Team

Усередині чотирьох конвеєрів перекладу, на яких працює InterMIND

Усередині чотирьох конвеєрів перекладу, на яких працює InterMIND

Стара сторінка /product/overview/how-it-works на mind.com відстала від актуального стану на кілька великих релізів. Вона описує єдиний «рушій перекладу» так, як це роблять більшість сторінок вендорів: одна велика стрілка від «ви говорите» до «вони чують». Ця картина була спрощенням уже два роки тому. Сьогодні вона хибна.

Насправді InterMIND працює на чотирьох окремих конвеєрах перекладу. Кожен розв'язує свою задачу, має власний рушій, власний бюджет затримки та власні межі якості. Спільний у них лише вибір мови. Рушій у них різний.

Це оновлена відповідь на запитання «як це працює».

Супутній матеріал: «Скільки мов ви підтримуєте?» розповідає, що саме охоплює кожен конвеєр (23 / 23 / 30 / 17). Ця стаття розповідає, що кожен конвеєр робить і чому він окремий.


Чому «один рушій для всього» — неправда

Платформа для живих зустрічей має виконувати щонайменше чотири завдання одночасно, і вони тягнуть у несумісних напрямках:

  1. Голос у реальному часі — на вході звук, на виході перекладений звук, поки спікер ще говорить, і кожен глядач чує його своєю мовою. Головне обмеження — затримка.
  2. Чат у реальному часі — короткі повідомлення, швидко, зі збереженням редагувань, цитат і HTML-структури.
  3. Спільні нотатки в реальному часі — спільний набір тексту символ за символом зі структурною ієрархією (списки, заголовки, чекбокси), яка має пережити переклад.
  4. Асинхронні файли документів — 40-сторінковий PDF, скинутий у чат. Бюджету затримки немає. Головне обмеження — точність відтворення: форматування, таблиці, номери сторінок, шрифт.

Можна зробити один гігантський виклик LLM, який намагається робити все це. Ми пробували. Він погано справляється з усім. Бюджет затримки для голосу означає, що модель не може «міркувати»; бюджет точності для документів означає, що мусить. Редагування в чаті потребує diff мовою глядача; 40-сторінковому PDF потрібне збереження формату, якого не дає жодна модель із потоковою видачею токенів.

Тож ми запускаємо чотири. Ось кожен із них.

Конвеєр 1: Голосовий переклад у реальному часі

Задача: Учасник говорить французькою. Другий приєднався німецькою, третій — бразильською португальською, четвертий — японською. Кожен має чути спікера своєю мовою, у своєму навушнику, із затримкою, достатньо короткою, щоб зберігався зоровий контакт.

Бюджет: слухач ніколи не повинен на це чекати. Щойно переклад мовлення відстає настільки, що люди починають говорити поверх нього, зустріч скочується до «давайте просто перейдемо на англійську».

Як насправді рухається звук

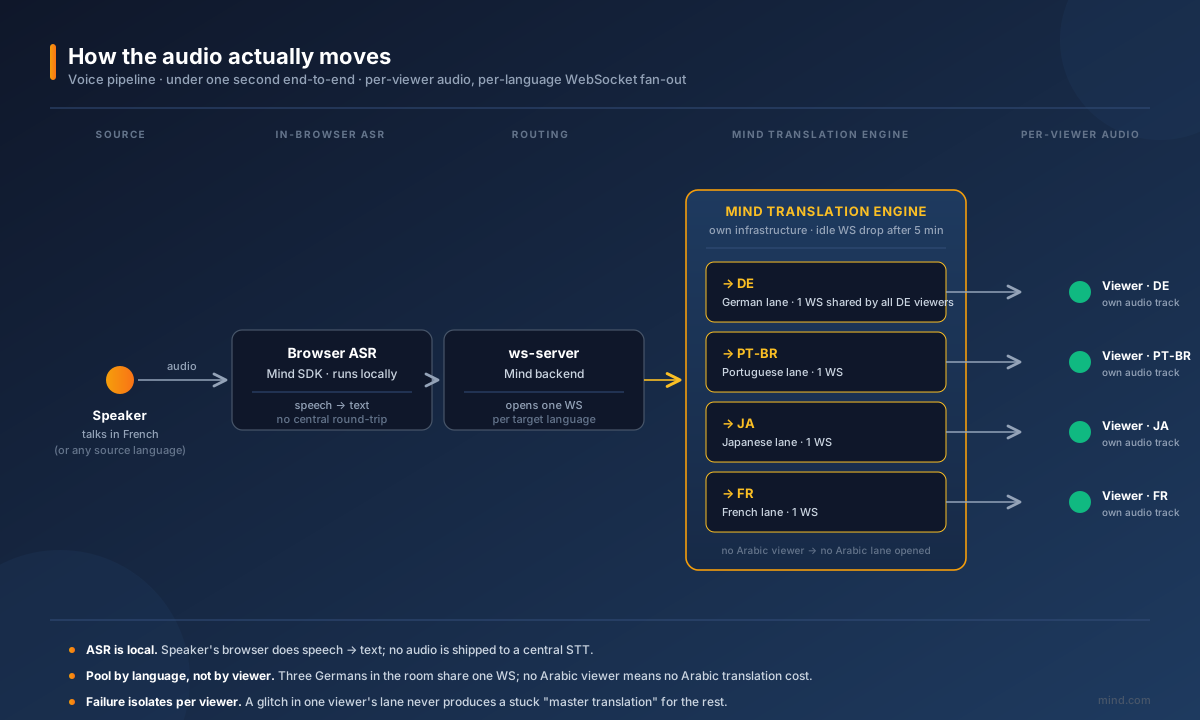
Конвеєр голосового перекладу: браузер спікера надсилає звук через WebRTC до нашого власного рушія — медіасервера Mind API в OVH, Франція — який виконує ASR і перекладає на кожну цільову мову, присутню в кімнаті; кожен глядач отримує власну перекладену звукову доріжку, а ws-server отримує слова транскрипту для підсумку.

Кілька речей варто назвати прямо:

  • ASR працює на медіасервері. Звук спікера йде через WebRTC до нашого власного рушія — Mind API в OVH, Франція — і розпізнається там, на тому самому сервері, що веде дзвінок; браузер лише надсилає звук і отримує слова назад. Жодного окремого мовленнєвого вендора й жодного зайвого переходу до початку перекладу. (Голосові нотатки в чаті — виняток: їхнє перетворення мовлення на текст виконує Azure AI Speech, мовленнєвий сервіс шлюзу ШІ за замовчуванням.)
  • Переклад — це не один «віяловий» розподіл. Рушій перекладає за цільовою мовою, присутньою в кімнаті, а не за глядачем: переклад на мову починається, коли перший слухач цією мовою запитує перекладений потік; троє учасників, які обрали німецьку, ділять один німецький переклад, а якщо арабською ніхто не слухає, то арабською нічого й не перекладається. Тому чотиримовна зустріч коштує стільки ж, скільки сорокамовна, з поправкою на те, хто фактично прийшов: ми ніколи не перекладаємо мовами, якими ніхто з учасників не слухає.
  • Синтезоване мовлення — для кожного глядача окреме. Кожен учасник отримує власну перекладену звукову доріжку, змішану з відео оригінального спікера. Вони не дивляться якусь головну «перекладену зустріч» — вони дивляться ту саму зустріч, у якій їхній особистий звуковий канал перекладено обраною мовою. Тому двоє людей в одній кімнаті можуть вдягнути навушники й чути різні мови.

Чому це важливо, коли зустріч іде не за планом

У 60-хвилинному дзвінку з вісьмома мовами все ламається цікавими способами: WebSocket-з'єднання рвуться, ASR тимчасово помиляється у власній назві, у когось нестабільна мережа. Описана архітектура дає змогу ізолювати збої: збій звуку в одного глядача не впливає на інших семи, бо рушій ніколи не створював «переклад» як такий — він створив вісім, паралельно, і відновлюватися доведеться лише постраждалому.

Сам рушій наш, розміщений на нашій власній інфраструктурі. Ми не пропускаємо голос у реальному часі через сторонні LLM загального призначення. Бюджет затримки їх виключає; питання резидентності даних виключає їх для регульованих клієнтів, яким це справді важливо.

Що ми публікуємо про якість голосу: /benchmark щомісяця запускає робочий голосовий конвеєр на реченнях FLORES-200 для кожної опублікованої мовної пари. Суддю названо (Gemini 3.7 Flash — основний, Claude Sonnet 5 — резервний). Повний розподіл — медіана, p10, p90, мінімум, максимум, розмір вибірки — на сторінці. Що ці числа вимірюють, а що ні, дивіться в методології.


Конвеєр 2: Переклад чату в реальному часі

Задача: Кожне повідомлення чату на зустрічі перекладається для кожного учасника його мовою в момент надсилання. Плюс редагування — а вони мають виглядати як редагування, а не як повторні переклади.

Бюджет: вільніший, ніж у голосу. Повідомлення в чаті може з'явитися іншою мовою з невеликою паузою, і нікого це не турбує. Людей хвилює, чи переклад правильний і чи редагування мають сенс.

Що насправді робить конвеєр чату

Кожне повідомлення проходить через той самий рушій перекладу, що й голосовий конвеєр, але з іншою попередньою та подальшою обробкою:

  • HTML-структура зберігається. Чат підтримує форматований текст (абзаци, списки, цитати, жирний, курсив). Ми перетворюємо його на простий текст для моделі, перекладаємо, а потім загортаємо результат в оригінальні теги. Модель ніколи не бачить HTML — вона бачить чисту прозу.
  • Цитати перекладаються окремо. Якщо ви відповідаєте на повідомлення й цитуєте його, блок [QUOTE]…[/QUOTE] і новий вміст перекладаються як окремі одиниці, щоб модель не сплутала їх.
  • Довгі повідомлення розбиваються на частини. Ми ділимо за межами абзаців по 1000 символів на частину. Кожна частина — окремий виклик перекладу. Ми не згодовуємо моделі «романи» на 4000 символів за один раз — збої (обрізання, втрачені абзаци, обриви посеред речення) надто неприємні.
  • Переклад відкладений. Ми використовуємо IntersectionObserver: повідомлення перекладається лише тоді, коли воно прокручується у видиму область глядача. Перемикання мов у каналі з довгою історією раніше повторювало кожен виклик API перекладу з історії. Тепер ні.

Цікава частина: редагування як diff

У v1.2 ми змінили поведінку редагувань у чаті для глядачів іншою мовою. Раніше було так: хтось редагує повідомлення, ми перекладаємо його заново цілком, ви бачите свіжий абзац і мусите вишукувати, що змінилося.

Нова поведінка:

  1. Оригінальне повідомлення вже перекладено вашою мовою.
  2. Коли відправник редагує, ми перекладаємо нову версію.
  3. Ми обчислюємо diff між вашим попереднім перекладом і вашим новим перекладом вашою мовою.
  4. Ми показуємо цей diff у тексті — так само, як Git показує, що змінилося.

Тож коли англійське «review by Tuesday» стає «review by Thursday», ваш іспаномовний колега бачить виділене martes → jueves, а не перекладений наново абзац, який треба перечитувати.

Для цього довелося розглядати конвеєр чату як станову кеш-пам'ять для кожного глядача, а не як безстановий ендпоінт «переклади на запит». Документам і голосу цього не потрібно. Чату — потрібно.


Конвеєр 3: Переклад спільних нотаток у реальному часі

Задача: Ведучий відкриває панель спільних нотаток і починає друкувати. Кожен учасник бачить нотатки своєю мовою, символ за символом, зі збереженою структурою документа — заголовками, вкладеними списками, чеклістами, блоками коду.

Бюджет: Як у чату, але з двома додатковими обмеженнями:

  • Те, що перекладається, змінюється просто під час перекладу. Ведучий ще друкує. Наївна система, що перекладає «весь документ» при кожному натисканні клавіші, дає мерехтіння й спалює бюджет API. Ми перекладаємо на рівні зміненої одиниці, а не всього документа.
  • Структура має вціліти. Якщо попросити модель перекладу перекласти markdown-блок із трьома вкладеними списками, ви отримаєте щось, що схоже на оригінал, але з непомітно сплощеною ієрархією, перенумерованими пунктами чи зсунутими відступами. Ми не дозволяємо моделі бачити весь блок.

Чим конвеєр нотаток відрізняється від чату

Головне тут — збереження структури. Ми перекладаємо кожен пункт списку окремо, а не як один документ. Модель бачить:

"Compliance review — Q2 deliverables"

— а не:

"# Project plan\n## Quarter\n- Compliance review — Q2 deliverables\n- Vendor scoring\n - Tier 1 vendors..."

Обгортка документа — <ul>, заголовки, відступи — відновлюється на боці клієнта за тією самою структурою, що була в оригіналі, а кожен листковий вузол замінюється своїм перекладом. Модель ніколи не отримує змоги «покращити» ієрархію.

Нотатки також використовують ту саму модель diff для кожного глядача, що й редагування в чаті: якщо ведучий змінює рядок, глядачі іншими мовами бачать виділені змінені слова, а не свіжий абзац.


Конвеєр 4: Асинхронний переклад документів

Задача: Хтось скидає в чат 40-сторінковий PDF, документ Word, презентацію PowerPoint або таблицю Excel. Кожен учасник може запросити копію своєю мовою. Перекладений файл має виглядати як оригінал — ті самі шрифти, ті самі таблиці, ті самі номери сторінок, ті самі колонтитули, ті самі діаграми на своїх місцях.

Бюджет: Обмеження реального часу немає. Хвилина — нормально. Дві хвилини — нормально. Обмеження — точність відтворення: якщо перекладений PDF не виглядає як оригінал, одержувач йому не довірятиме.

Чому цей конвеєр не ділить рушій із голосом

Загальна LLM, навіть дуже добра, поверне вам перекладений текст документа. Вона не поверне перекладений PDF з тим самим макетом. Модель не має поняття «розрив сторінки, який має збігатися з джерелом» чи «клітинка таблиці, що має зберегти ширину стовпця».

Для цієї поверхні ми використовуємо DeepL Document API напряму. Він створений для перекладу файлів як файлів, а не прози, витягнутої з файлів. DeepL обробляє:

  • PDF (зі збереженням макета)
  • DOCX, DOC
  • PPTX
  • XLSX

Документ завантажується в конвеєр DeepL, перекладається на стороні сервера зі збереженим форматуванням і повертається в тому самому форматі. Потім ми завантажуємо результат у наше об'єктне сховище й повертаємо його в чат як вкладення для завантаження.

Скільки це коштує і чому ми цього не ховаємо

DeepL виставляє мінімум 50 000 символів за документ — приблизно один долар США за файл на тарифі Pro, незалежно від того, одна в документі сторінка чи тридцять. Ми беремо ці витрати на себе, а не стягуємо плату за файл; вони відображаються у використанні перекладу на зустрічі як оплачені символи, переведені в одиниці слів, що відповідають тому, як решта продукту звітує про активність перекладу.

Ми обрали DeepL для цієї поверхні, бо переклад файлів як файлів — саме те, для чого його створено, і ми не намагалися зробити кращий. Навпаки це не так: DeepL не має конвеєра живого голосу того типу, який ми створили для зустрічей. Різні задачі — різні інструменти. Чесна версія відповіді на запитання «що забезпечує переклад в InterMIND» — «правильний рушій для кожного конвеєра», а не «наш рушій усюди».

Мови, які цей конвеєр охоплює, а голос — ні

Конвеєр документів охоплює 30 мов проти 23 для голосу. Серед додаткових: болгарська, грецька, естонська, індонезійська, литовська, латиська, словацька, словенська. (Арабська також у цьому списку й є однією з додаткових: її вилучено з вибору мов реального часу, доки якість її голосу нижча за нашу планку, а оцінки за її парами залишаються публічними на /benchmark — саме це число поверне її. Асиметрія в зворотний бік стосується гінді — вона є для голосу, але ще не для файлів.)

Ця асиметрія реальна. Вона означає, що французький учасник зустрічі може запросити PDF договору естонською, хоча слухати зустріч естонською не може. Ми позначаємо це у виборі мови, а не маскуємо єдиним числом. Міркування наведено в статті про кількість мов.


Де конвеєри зустрічаються

Чотири конвеєри не працюють ізольовано. Кімната зустрічі — це місце, де вони стикаються, і шви мають значення:

  • Повідомлення в чаті з вкладеним документом запускає конвеєр чату для тексту й конвеєр документів для файлу. Учасник іншою мовою одразу бачить перекладене повідомлення, а переклад вкладення надходить асинхронно як файл для завантаження.
  • Спільна нотатка, що цитує рядок транскрипту, перетинає нотатки ↔ голос. Транскрипт — це те, що голосовий конвеєр видав для мови відправника; переклад нотатки створює для кожного глядача власну копію цієї цитати мовою решти, зі збереженим посиланням на джерело.
  • Транскрипт, експортований після зустрічі, проходить через текстовий конвеєр у стилі чату по всій розмові й дає файл для кожної мови, який учасники можуть завантажити. Це той самий шлях коду, що й переклад чату, тільки пакетний.

Вибір мови — це один елемент інтерфейсу. Інфраструктура під ним — чотири конвеєри, що спілкуються між собою.


Чого ми свідомо не намагаємося робити

  • Жодної «єдиної моделі перекладу». Ми не будуємо одну модель, яка робить голос, чат, нотатки й документи. У компромісі між затримкою та точністю немає переможця. Ми використовуємо правильний рушій для кожної поверхні.
  • Жодного тихого перенаправлення. Якщо конвеєр файлів сьогодні не може перекласти гінді, ми не відкочуємося мовчки до голосового рушія, вдаючи, що все вийшло — вибір мови для файлів позначає прогалину, а не ховає її.
  • Жодного «ми перекладаємо 200 мовами». Наш рушій видає 24. Живі поверхні підтримують 23, документи — 30, і замість одного маркетингово-зручного числа якість за кожною парою, яка має витримати перевірку аудитора, опублікована на /benchmark, разом зі слабшими парами.

Спробуйте самі

  • Спробуйте живе демо — запускає живий голосовий конвеєр на вашому звуці, будь-якою з 23 мов продукту. Той самий конвеєр, що отримує оцінки на /benchmark.
  • Перегляньте бенчмарк — якість за кожною парою й кожним місяцем на реальному трафіку. Кожна пара у виборі мови, сильна чи слабка, має пряме посилання.
  • Прочитайте методологію — що це за числа, чого вони не показують, хто суддя.

Чотири конвеєри, чотири рушії, одна кімната зустрічі. Це чесна заміна старій сторінці how-it-works.

— Команда Mind.com


Джерела: DeepL — підтримувані мови, DeepL — облік використання та оплата (мінімум 50 000 символів за файл), FLORES-200; внутрішні факти про конвеєри перевірено за випущеним кодом, станом на серпень 2026 року.

Більше в розділі «Живий переклад»

Усі публікації в розділі «Живий переклад»
Англійська — для першого контакту. Угода ж відбувається мовою партнера
Живий переклад

Англійська — для першого контакту. Угода ж відбувається мовою партнера

Де англійська закінчується в експортній угоді, етап за етапом: запит, комерційна пропозиція, переговори, рекламація, наступне замовлення. Скільки експортний відділ платить за мову партнера сьогодні — з цінами та джерелами — і що залишається за угодою після її завершення.

The Mind.com Team

Голосовий перекладач для турецької: дієслово стоїть у кінці, і саме це визначає, який вам потрібен
Живий переклад

Голосовий перекладач для турецької: дієслово стоїть у кінці, і саме це визначає, який вам потрібен

У турецькій мові дієслово, заперечення і час стоять наприкінці речення. Саме цей факт розрізняє три продукти, які продають як «голосовий перекладач»: мобільні застосунки, навушники-перекладачі та живий переклад на зустрічах. Що кожен із них може й чого не може зробити з турецьким реченням і чому кількість мов, яку заявляє постачальник, нічого не говорить про цю мовну пару.

The Mind.com Team

Синхронний перекладач: людина, платформа RSI чи AI — що потрібно вашій багатомовній зустрічі (2026)
Живий переклад

Синхронний перекладач: людина, платформа RSI чи AI — що потрібно вашій багатомовній зустрічі (2026)

«Синхронний перекладач» — це професія, а більшість запитів насправді стосується мовлення, яке надходить іншою мовою в момент, коли його вимовляють. Цей посібник розрізняє кабіну, платформу RSI та AI-синхронний переклад, порівнює інструменти за їхньою документацією — Interprefy, KUDO, Wordly, DeepL Voice, Zoom, Teams, Google Meet, InterMIND — і ставить питання, яке порівняння оминають: яка частина зустрічі справді повертається вашою мовою та де обробляються дані.

The Mind.com Team

Отримуйте нові публікації та оновлення продукту на email

Один лист на місяць із новими публікаціями та оновленнями продукту. Скасувати підписку можна будь-коли.