Di dalam empat saluran terjemahan yang menggerakkan InterMIND

Dalam InterMIND, tiada satu "terjemahan" yang tunggal. Terdapat empat saluran — suara, sembang, nota, dokumen — masing-masing dengan enjin, bajet kependaman dan lingkungan kualitinya sendiri. Inilah yang sebenarnya berlaku antara saat anda bercakap dan saat peserta dalam bahasa lain memahami anda.

The Mind.com Team

  • Empat saluran, bukan satu enjin. Suara, sembang, nota dan dokumen masing-masing berjalan pada enjin, belanjawan kependaman dan lingkungan kualiti tersendiri. Yang dikongsi hanyalah pemilih bahasa.
  • Tugas berbeza, enjin berbeza. Suara dijalankan bagi setiap bahasa sasaran dalam bilik pada enjin kami sendiri di Perancis, manakala dokumen dihantar ke Document API DeepL: 23 dan 30 bahasa.
  • InterMIND mengekalkan keseluruhan mesyuarat dalam bahasa setiap ahli, iaitu suara, sembang, nota dan fail, dengan kualiti bagi setiap pasangan bahasa diterbitkan setiap bulan. Tetamu menyertai secara percuma melalui pautan, tanpa akaun, dan anda hanya membayar untuk ahli yang aktif.
Di dalam empat saluran terjemahan yang menggerakkan InterMIND

Di sebalik empat saluran terjemahan yang menjalankan InterMIND

Halaman lama /product/overview/how-it-works di mind.com sudah ketinggalan beberapa keluaran utama. Halaman itu menggambarkan satu "enjin terjemahan" seperti kebanyakan halaman vendor: satu anak panah besar dari "anda bercakap" kepada "mereka mendengar". Gambaran itu sudah terlalu ringkas dua tahun lalu. Hari ini ia salah.

Hakikatnya, InterMIND menjalankan empat saluran terjemahan yang berasingan. Setiap satu menyelesaikan masalah yang berbeza dengan enjin yang berbeza, belanjawan kependaman yang berbeza dan lingkungan kualiti yang berbeza. Kesemuanya berkongsi pemilih bahasa, tetapi tidak berkongsi enjin.

Inilah jawapan terkini kepada soalan "bagaimana ia berfungsi".

Artikel pendamping: "Berapa banyak bahasa yang anda sokong?" menerangkan apa yang dilitupi oleh setiap saluran (23 / 23 / 30 / 17). Artikel ini pula menerangkan apa yang dilakukan oleh setiap saluran, dan sebab ia berdiri sendiri.


Mengapa "satu enjin untuk semuanya" itu tidak benar

Platform mesyuarat langsung perlu melakukan sekurang-kurangnya empat tugas serentak, dan tugas-tugas ini menuju ke arah yang bercanggah:

  1. Suara masa nyata — audio masuk, audio terjemahan keluar semasa penutur masih bercakap, dengan setiap penonton mendengar dalam bahasanya sendiri. Kekangan utamanya ialah kependaman.
  2. Teks sembang masa nyata — mesej pendek dan pantas, dengan suntingan, petikan dan struktur HTML dikekalkan.
  3. Nota kongsi masa nyata — penaipan kolaboratif aksara demi aksara, dengan hierarki struktur (senarai, tajuk, kotak semak) yang mesti terselamat daripada terjemahan.
  4. Fail dokumen tak segerak — PDF 40 halaman yang dilepaskan ke dalam sembang. Tiada belanjawan kependaman. Kekangan utamanya ialah kesetiaan: pemformatan, jadual, nombor halaman dan fon.

Anda boleh membina satu panggilan LLM besar yang cuba melakukan keempat-empatnya. Kami sudah mencubanya. Hasilnya lemah dalam keempat-empatnya. Belanjawan kependaman untuk suara bermakna model tidak sempat berfikir, sedangkan belanjawan kesetiaan untuk dokumen bermakna model mesti berfikir. Suntingan sembang memerlukan diff dalam bahasa penonton, manakala PDF 40 halaman memerlukan pengekalan format yang tidak dapat diberikan oleh mana-mana model penstriman token.

Jadi kami menjalankan empat. Berikut setiap satunya.


Saluran 1: Terjemahan suara masa nyata

Masalahnya: Seorang peserta bercakap bahasa Perancis. Seorang lagi menyertai dalam bahasa Jerman, yang ketiga dalam bahasa Portugis Brazil, dan yang keempat dalam bahasa Jepun. Setiap seorang perlu mendengar penutur dalam bahasanya sendiri, di telinganya sendiri, dengan kelewatan yang cukup singkat untuk membolehkan pandangan mata terus terjalin.

Belanjawannya: pendengar tidak boleh sekali-kali menunggu. Apabila ucapan terjemahan terlewat sehingga orang mula bercakap melampauinya, mesyuarat condong ke arah "jom beralih ke bahasa Inggeris sahaja".

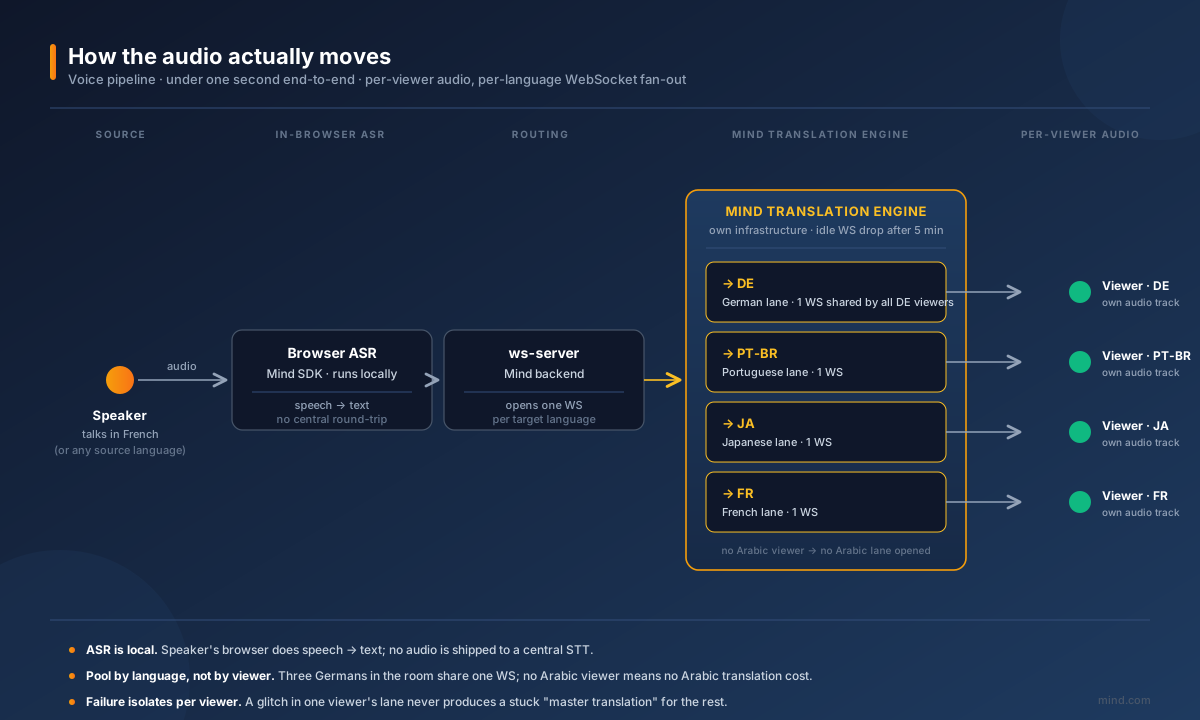
Bagaimana audio sebenarnya bergerak

Saluran terjemahan suara: pelayar penutur menghantar audio melalui WebRTC ke enjin kami sendiri — pelayan media Mind API di OVH, Perancis — yang menjalankan ASR dan menterjemah ke setiap bahasa sasaran yang hadir dalam bilik; setiap penonton menerima runut audio terjemahannya sendiri, dan ws-server menerima perkataan transkrip untuk rekap.

Beberapa perkara yang wajar disebut dengan jelas:

  • ASR berjalan pada pelayan media. Audio penutur bergerak melalui WebRTC ke enjin kami sendiri — Mind API di OVH, Perancis — dan dikenali di sana, pada pelayan yang sama yang membawa panggilan itu; pelayar hanya menghantar audio dan menerima perkataan kembali. Tiada vendor pertuturan yang berasingan dan tiada lompatan tambahan sebelum terjemahan boleh bermula. (Nota suara sembang ialah pengecualian: penukaran pertuturan-ke-teksnya berjalan pada Azure AI Speech, perkhidmatan pertuturan bagi get laluan AI lalai.)
  • Terjemahan bukan satu fan-out. Enjin menterjemah bagi setiap bahasa sasaran yang hadir dalam bilik, bukan bagi setiap penonton: terjemahan ke dalam sesuatu bahasa bermula apabila pendengar pertama dalam bahasa itu meminta strim terjemahan, tiga peserta yang memilih bahasa Jerman berkongsi satu terjemahan Jerman, dan jika tiada sesiapa mendengar dalam bahasa Arab, tiada apa yang diterjemah ke bahasa Arab. Inilah sebabnya mesyuarat empat bahasa mempunyai kos yang sama dengan mesyuarat empat puluh bahasa, bergantung pada siapa yang benar-benar hadir — kami tidak pernah menterjemah ke bahasa yang tiada peserta mendengarnya.
  • Pertuturan tersintesis dibuat bagi setiap penonton. Setiap peserta menerima runut audio terjemahannya sendiri, yang dicampur dengan video penutur asal. Mereka tidak menonton "mesyuarat terjemahan" induk — mereka menonton mesyuarat yang sama, dengan saluran audio peribadi mereka diterjemah ke bahasa pilihan mereka. Inilah sebabnya dua orang dalam bilik fizikal yang sama boleh masing-masing memasang fon kepala dan mendengar bahasa yang berbeza.

Mengapa ini penting apabila mesyuarat tidak berjalan lancar

Dalam panggilan 60 minit dengan lapan bahasa, pelbagai perkara boleh rosak dengan cara yang menarik: WebSocket terputus, ASR tersalah transkrip kata nama khas buat seketika, rangkaian seorang peserta menjadi tidak stabil. Senibina di atas membolehkan kami mengasingkan kegagalan: audio seorang penonton yang terganggu tidak menjejaskan tujuh yang lain, kerana enjin terjemahan tidak pernah menghasilkan "terjemahan" itu sekali gus — ia menghasilkan lapan, secara selari, dan hanya yang terjejas perlu pulih.

Enjin itu sendiri milik kami, dihoskan pada infrastruktur kami sendiri. Kami tidak menyalurkan suara masa nyata melalui LLM serba guna pihak ketiga. Belanjawan kependaman menolaknya; kisah residensi data pula menolaknya bagi pelanggan terkawal yang benar-benar mengambil berat.

Apa yang kami terbitkan tentang kualiti suara: /benchmark menjalankan saluran suara pengeluaran terhadap ayat FLORES-200 bagi setiap pasangan bahasa yang diterbitkan, setiap bulan. Penilainya dinamakan (Gemini 3.7 Flash utama, Claude Sonnet 5 sandaran). Taburan penuh — median, p10, p90, minimum, maksimum, saiz sampel — ada pada halaman itu. Lihat metodologi untuk apa yang diukur dan tidak diukur oleh angka-angka tersebut.


Saluran 2: Terjemahan sembang masa nyata

Masalahnya: Setiap mesej sembang dalam mesyuarat diterjemah untuk setiap peserta dalam bahasanya sendiri, sebaik sahaja ia dihantar. Termasuk suntingan — dan suntingan perlu kelihatan seperti suntingan, bukan seperti terjemahan semula.

Belanjawannya: lebih longgar daripada suara. Mesej sembang boleh mengambil seketika untuk muncul dalam bahasa lain tanpa sesiapa peduli. Yang dipedulikan orang ialah sama ada terjemahan itu betul dan sama ada suntingan masuk akal.

Apa yang sebenarnya dilakukan oleh saluran sembang

Setiap mesej melalui enjin terjemahan yang sama seperti yang digunakan oleh saluran suara — tetapi dengan prapemprosesan dan pascapemprosesan yang berbeza:

  • Struktur HTML dikekalkan. Sembang menyokong teks kaya (perenggan, senarai, petikan, tebal, condong). Kami menukarnya kepada teks biasa untuk model, menterjemah, kemudian membalut semula hasilnya dalam teg asal. Model tidak pernah melihat HTML — ia melihat prosa yang bersih.
  • Petikan diterjemah secara bebas. Jika anda membalas sesuatu mesej dan memetiknya, blok [QUOTE]…[/QUOTE] dan kandungan baharu diterjemah sebagai unit yang berasingan, supaya model tidak keliru antara keduanya.
  • Mesej panjang dipecah kepada ketulan. Kami memisahkan pada sempadan perenggan pada 1,000 aksara bagi setiap ketulan. Setiap ketulan ialah satu panggilan terjemahan tersendiri. Kami tidak menyuap "novel" 4,000 aksara kepada model sekali gus — mod kegagalannya (pemotongan, perenggan hilang, ayat terpotong di tengah) terlalu teruk.
  • Terjemahan bersifat malas. Kami menggunakan IntersectionObserver: sesuatu mesej hanya diterjemah apabila ia tergulung masuk ke tetingkap paparan penonton. Menukar bahasa dalam saluran yang telah lama berjalan dahulu mengulang setiap panggilan API terjemahan daripada sejarah. Kini tidak lagi.

Bahagian yang menarik: suntingan sebagai diff

Dalam v1.2 kami mengubah cara suntingan sembang berfungsi bagi penonton dalam bahasa lain. Tingkah laku lama: seseorang menyunting mesej, kami menterjemah semula keseluruhannya, anda melihat perenggan baharu dan perlu mencari sendiri apa yang berubah.

Tingkah laku baharu:

  1. Mesej asal sudah pun diterjemah ke bahasa anda.
  2. Apabila penghantar menyunting, kami menterjemah semula versi baharu.
  3. Kami mengira diff antara terjemahan anda sebelum ini dan terjemahan baharu anda, dalam bahasa anda.
  4. Kami memaparkan diff itu sebaris — sama seperti cara Git menunjukkan apa yang berubah.

Jadi apabila "review by Tuesday" menjadi "review by Thursday" dalam bahasa Inggeris, rakan sekerja anda yang membaca dalam bahasa Sepanyol melihat martes → jueves diserlahkan, bukan perenggan terjemahan semula yang perlu dibaca semula.

Ini memerlukan saluran sembang diperlakukan sebagai cache berkeadaan bagi setiap penonton, bukan titik akhir terjemah-atas-permintaan yang tanpa keadaan. Dokumen dan suara tidak memerlukannya. Sembang memerlukannya.


Saluran 3: Terjemahan nota kongsi masa nyata

Masalahnya: Hos membuka panel nota kongsi dan mula menaip. Setiap peserta melihat nota dalam bahasanya, aksara demi aksara, dengan struktur dokumen — tajuk, senarai bersarang, senarai semak, blok kod — kekal utuh.

Belanjawannya: Sama seperti sembang, tetapi dengan dua kekangan tambahan:

  • Perkara yang diterjemah berubah semasa penterjemahan. Hos masih menaip. Sistem naif yang menterjemah "keseluruhan dokumen" pada setiap ketukan kekunci menghasilkan kerlipan dan menghabiskan belanjawan API. Kami menterjemah pada tahap unit yang berubah, bukan keseluruhan dokumen.
  • Struktur mesti terselamat. Jika anda meminta model terjemahan menterjemah gumpalan markdown dengan tiga senarai bersarang, anda akan mendapat sesuatu yang kelihatan seperti yang asal tetapi dengan hierarki yang diratakan secara halus, item bernombor semula, atau inden yang berpindah. Kami tidak membenarkan model melihat keseluruhan gumpalan itu.

Bagaimana saluran nota berbeza daripada sembang

Pengekalan struktur ialah perkara utama. Kami menterjemah setiap item senarai secara bebas dan bukannya sebagai satu dokumen. Model melihat:

"Compliance review — Q2 deliverables"

— bukan:

"# Project plan\n## Quarter\n- Compliance review — Q2 deliverables\n- Vendor scoring\n - Tier 1 vendors..."

Dokumen pembalut — <ul>, tajuk, inden — dibina semula di sisi klien menggunakan struktur yang sama seperti dokumen asal, dengan setiap nod daun digantikan dengan terjemahannya. Model tidak pernah berpeluang untuk "memperbaiki" hierarki.

Nota juga menggunakan model diff bagi setiap penonton yang sama seperti suntingan sembang: jika hos mengubah satu baris, penonton dalam bahasa lain melihat perkataan yang berubah diserlahkan, bukan perenggan baharu.


Saluran 4: Terjemahan dokumen tak segerak

Masalahnya: Seseorang melepaskan PDF 40 halaman, dokumen Word, dek PowerPoint atau helaian Excel ke dalam sembang. Setiap peserta boleh meminta salinan dalam bahasanya sendiri. Fail terjemahan mesti kelihatan seperti yang asal — fon yang sama, jadual yang sama, nombor halaman yang sama, pengepala yang sama, carta yang sama pada tempatnya.

Belanjawannya: Tiada kekangan masa nyata. Seminit tidak mengapa. Dua minit pun tidak mengapa. Kekangannya ialah kesetiaan — jika PDF terjemahan tidak kelihatan seperti yang asal, penerima tidak akan mempercayainya.

Mengapa saluran ini tidak berkongsi enjin dengan suara

LLM am, walau sebaik mana pun, akan memberi anda teks dokumen yang diterjemah. Ia tidak akan memberi anda PDF terjemahan dengan susun atur yang sama. Model tidak mempunyai konsep "pemisah halaman yang mesti sejajar dengan sumber" atau "sel jadual yang mesti mengekalkan lebar lajurnya".

Untuk permukaan ini kami menggunakan DeepL Document API secara terus. Ia dibina khusus untuk menterjemah fail sebagai fail, bukan prosa yang diekstrak daripada fail. DeepL mengendalikan:

  • PDF (dengan pengekalan susun atur)
  • DOCX, DOC
  • PPTX
  • XLSX

Dokumen dimuat naik ke saluran DeepL, diterjemah di sisi pelayan dengan pemformatan utuh, dan dikembalikan dalam format yang sama. Kami kemudian memuat naik hasilnya ke storan objek kami dan memaparkannya semula dalam sembang sebagai lampiran yang boleh dimuat turun.

Apa kos ini dan mengapa kami tidak menyembunyikannya

DeepL mengenakan minimum 50,000 aksara bagi setiap dokumen — kira-kira satu dolar AS bagi setiap fail pada peringkat Pro, tanpa mengira sama ada dokumen itu satu halaman atau tiga puluh. Kami menanggung kos itu dan tidak mengenakan bayaran bagi setiap fail; ia muncul dalam penggunaan terjemahan mesyuarat sebagai aksara dibilkan, ditukar kepada unit perkataan yang sepadan dengan cara bahagian produk yang lain melaporkan aktiviti terjemahan.

Kami memilih DeepL untuk permukaan ini kerana menterjemah fail sebagai fail memang tugas yang untuknya ia dibina — kami tidak cuba membina yang lebih baik. Sebaliknya tidak benar: DeepL tidak menjalankan saluran suara langsung seperti yang kami bina untuk mesyuarat. Masalah berbeza; alat berbeza. Versi jujur bagi "apa yang menggerakkan terjemahan InterMIND" ialah "enjin yang tepat bagi setiap saluran" — bukan "enjin kami, di mana-mana".

Bahasa yang dilitupi saluran ini tetapi tidak oleh suara

Saluran dokumen mencapai 30 bahasa, berbanding 23 bagi suara. Tambahannya termasuk: Bulgaria, Yunani, Estonia, Indonesia, Lithuania, Latvia, Slovak, Slovenia. (Bahasa Arab juga ada dalam senarai ini, dan ia salah satu tambahan: ia ditarik balik daripada pemilih masa nyata selagi kualiti suaranya di bawah paras kami, dan skor setiap pasangannya kekal awam di /benchmark — angka itulah yang akan membawanya kembali. Ketidakseimbangan itu berlaku sebaliknya bagi bahasa Hindi — aktif untuk suara, belum lagi untuk fail.)

Ketidakseimbangan itu nyata. Ia bermakna peserta Perancis dalam mesyuarat boleh meminta PDF kontrak dalam bahasa Estonia walaupun dia tidak dapat mendengar mesyuarat dalam bahasa Estonia. Kami menandakannya dalam pemilih dan bukannya melicinkannya dengan satu angka. Alasannya ada dalam artikel bilangan bahasa.


Tempat saluran-saluran ini bertemu

Keempat-empat saluran tidak berjalan secara terpencil. Bilik mesyuarat ialah tempat ia bersentuhan, dan sambungan di antaranya penting:

  • Mesej sembang dengan lampiran dokumen mencetuskan saluran sembang untuk teks dan saluran dokumen untuk fail. Peserta dalam bahasa lain melihat mesej itu diterjemah serta-merta, dan terjemahan lampiran tiba secara tak segerak sebagai fail yang boleh dimuat turun.
  • Nota kongsi yang memetik baris transkrip merentasi nota ↔ suara. Transkrip ialah apa yang dihasilkan oleh saluran suara dalam bahasa penghantar; terjemahan nota menghasilkan salinan petikan itu bagi setiap penonton dalam bahasa semua orang lain, dengan atribusi sumbernya dikekalkan.
  • Transkrip yang dieksport selepas mesyuarat menjalankan saluran teks gaya sembang ke atas keseluruhan perbualan, menghasilkan fail bagi setiap bahasa yang boleh dimuat turun peserta. Ini laluan kod yang sama seperti terjemahan sembang, cuma diproses secara kelompok.

Pemilih bahasa ialah satu bahagian UI. Infrastruktur di bawahnya ialah empat saluran yang saling berhubung.


Apa yang sengaja tidak kami cuba

  • Tiada "model terjemahan bersepadu". Kami tidak membina satu model yang melakukan suara, sembang, nota dan dokumen. Pertukaran antara kependaman dan kesetiaan tidak mempunyai pemenang. Kami menggunakan enjin yang tepat bagi setiap permukaan.
  • Tiada penghalaan semula secara senyap. Jika saluran fail tidak dapat menterjemah ke bahasa Hindi hari ini, kami tidak senyap-senyap beralih kepada enjin suara dan berpura-pura ia berjaya — pemilih fail menandakan jurang itu dan bukannya menyembunyikannya.
  • Tiada "kami menterjemah ke 200 bahasa". Enjin kami menghasilkan 24. Permukaan langsung menyokong 23, dokumen 30 — dan sebagai ganti satu angka yang mesra pemasaran, kualiti bagi setiap pasangan yang perlu berdiri di hadapan juruaudit diterbitkan di /benchmark, termasuk pasangan yang lebih lemah.

Cuba sendiri

  • Cuba demo langsung — menjalankan saluran suara langsung terhadap audio anda, dalam mana-mana 23 bahasa produk. Saluran yang sama yang dinilai di /benchmark.
  • Lihat penanda aras — kualiti bagi setiap pasangan, setiap bulan, pada trafik sebenar. Setiap pasangan dalam pemilih, kuat atau lemah, boleh dipautkan terus.
  • Baca metodologi — apakah angka-angka itu, apa yang bukan, dan siapa penilainya.

Empat saluran, empat enjin, satu bilik mesyuarat. Itulah pengganti yang jujur bagi halaman lama how-it-works.

— Pasukan Mind.com


Sumber: DeepL — bahasa yang disokong, DeepL — kiraan penggunaan dan pengebilan (minimum 50,000 aksara bagi setiap fail), FLORES-200; fakta saluran dalaman disahkan terhadap kod yang dihantar, disemak pada Ogos 2026.

Lagi dalam Terjemahan langsung

Semua catatan dalam Terjemahan langsung
Bahasa Inggeris untuk hubungan pertama. Urus niaga berjalan dalam bahasa rakan kongsi
Terjemahan langsung

Bahasa Inggeris untuk hubungan pertama. Urus niaga berjalan dalam bahasa rakan kongsi

Di mana bahasa Inggeris tidak lagi mencukupi dalam urus niaga eksport, peringkat demi peringkat: pertanyaan, sebut harga, rundingan, tuntutan, pesanan seterusnya. Apa yang dibayar oleh meja eksport untuk bahasa rakan kongsi hari ini, lengkap dengan harga dan sumber, serta apa yang kekal bersama urus niaga selepas itu.

The Mind.com Team

Penterjemah suara Turki: kata kerja datang terakhir, dan itu menentukan yang mana satu anda perlukan
Terjemahan langsung

Penterjemah suara Turki: kata kerja datang terakhir, dan itu menentukan yang mana satu anda perlukan

Bahasa Turki meletakkan kata kerja — serta penafian dan kala — di hujung ayat. Fakta tunggal itu membezakan tiga produk yang dijual sebagai "penterjemah suara": aplikasi telefon, fon telinga penterjemah dan terjemahan meeting secara langsung. Apa yang boleh dan tidak boleh dilakukan oleh setiap satu terhadap ayat Turki, dan mengapa jumlah bahasa yang didakwa oleh vendor tidak memberitahu anda apa-apa tentang pasangan bahasa ini.

The Mind.com Team

Jurubahasa serentak: manusia, platform RSI atau AI — apa yang diperlukan oleh mesyuarat berbilang bahasa anda (2026)
Terjemahan langsung

Jurubahasa serentak: manusia, platform RSI atau AI — apa yang diperlukan oleh mesyuarat berbilang bahasa anda (2026)

"Jurubahasa serentak" ialah satu profesion; apa yang sebenarnya dicari oleh kebanyakan carian ialah ucapan yang sampai dalam bahasa lain semasa ia sedang dituturkan. Panduan ini membezakan bilik jurubahasa (booth), platform RSI dan terjemahan serentak AI, membandingkan alat-alat tersebut berdasarkan dokumentasi mereka — Interprefy, KUDO, Wordly, DeepL Voice, Zoom, Teams, Google Meet, InterMIND — dan mempersoalkan perkara yang dilangkau oleh perbandingan itu: setakat mana kandungan mesyuarat benar-benar kembali dalam bahasa anda, dan di mana data diproses.

The Mind.com Team

Dapatkan catatan baharu dan kemas kini produk melalui e-mel

Satu e-mel sebulan dengan catatan baharu dan kemas kini produk. Berhenti melanggan pada bila-bila masa.