Вътре в четирите конвейера за превод, които задвижват InterMIND

В InterMIND не съществува единен „превод“. Има четири конвейера — глас, чат, бележки, документи — всеки със собствен механизъм, бюджет за забавяне и обхват на качеството. Ето какво всъщност се случва между момента, в който заговорите, и момента, в който участник на друг език ви разбира.

The Mind.com Team

  • Четири пайплайна, а не един двигател. Гласът, чатът, бележките и документите работят всеки със свой двигател, свой бюджет за забавяне и свой обхват на качеството. Общ е само изборът на език.
  • Различни задачи, различни двигатели. Гласът се превежда за всеки целеви език в стаята на наш собствен двигател във Франция, а документите минават през Document API на DeepL: 23 и 30 езика.
  • InterMIND държи цялата среща на езика на всеки участник: глас, чат, бележки и файлове, а качеството по двойки езици се публикува всеки месец. Гостите се присъединяват безплатно с връзка, без акаунт, а вие плащате само за активните членове.
Вътре в четирите конвейера за превод, които задвижват InterMIND

Вътре в четирите пайплайна за превод, на които работи InterMIND

Старата страница /product/overview/how-it-works на mind.com изостава с няколко големи версии. Тя описва един-единствен „двигател за превод“, както правят повечето страници на доставчици: една голяма стрелка от „вие говорите“ към „те чуват“. Тази картина беше опростяване още преди две години. Днес е грешна.

Истината е, че InterMIND работи с четири отделни пайплайна за превод. Всеки решава различен проблем с различен двигател, различен бюджет за забавяне и различен обхват на качеството. Те споделят избора на език, но не и двигател.

Това е актуализираният отговор на въпроса „как работи“.

Придружаваща статия: „Колко езика поддържате?“ разглежда какво покрива всеки пайплайн (23 / 23 / 30 / 17). Тази статия разглежда какво прави всеки пайплайн и защо е отделна система.


Защо „един двигател за всичко“ е заблуда

Платформата за живи срещи трябва да върши поне четири задачи едновременно, а те дърпат в несъвместими посоки:

  1. Глас в реално време — аудио на входа, преведено аудио на изхода, докато говорещият още говори, като всеки зрител го чува на своя език. Тук ограничението е забавянето.
  2. Чат текст в реално време — кратки съобщения, бързо, със запазени редакции, цитати и HTML структура.
  3. Споделени бележки в реално време — съвместно писане символ по символ със структурна йерархия (списъци, заглавия, отметки), която трябва да оцелее при превода.
  4. Асинхронни файлове с документи — 40-странично PDF, пуснато в чата. Няма бюджет за забавяне. Ограничението е точността: форматиране, таблици, номера на страници, шрифт.

Може да се изгради едно гигантско извикване на LLM, което се опитва да прави и четирите неща. Опитахме. Справя се зле и с четирите. Бюджетът за забавяне при гласа означава, че моделът няма време да мисли, а бюджетът за точност при документите изисква точно това. Редакцията в чата изисква разлика (diff) на езика на зрителя, а 40-страничното PDF изисква запазване на формата, което никой модел с поточно генериране на токени не дава.

Затова пускаме четири. Ето всеки от тях.


Пайплайн 1: Превод на глас в реално време

Проблемът: Един участник говори френски. Друг се е присъединил на немски, трети на бразилски португалски, четвърти на японски. Всеки трябва да чува говорещия на собствения си език, в собственото си ухо, със закъснение, достатъчно кратко, за да е възможен зрителен контакт.

Бюджетът: слушателят никога не бива да чака. Щом преведената реч изостава дотолкова, че хората започват да говорят върху нея, срещата клони към „хайде просто да минем на английски“.

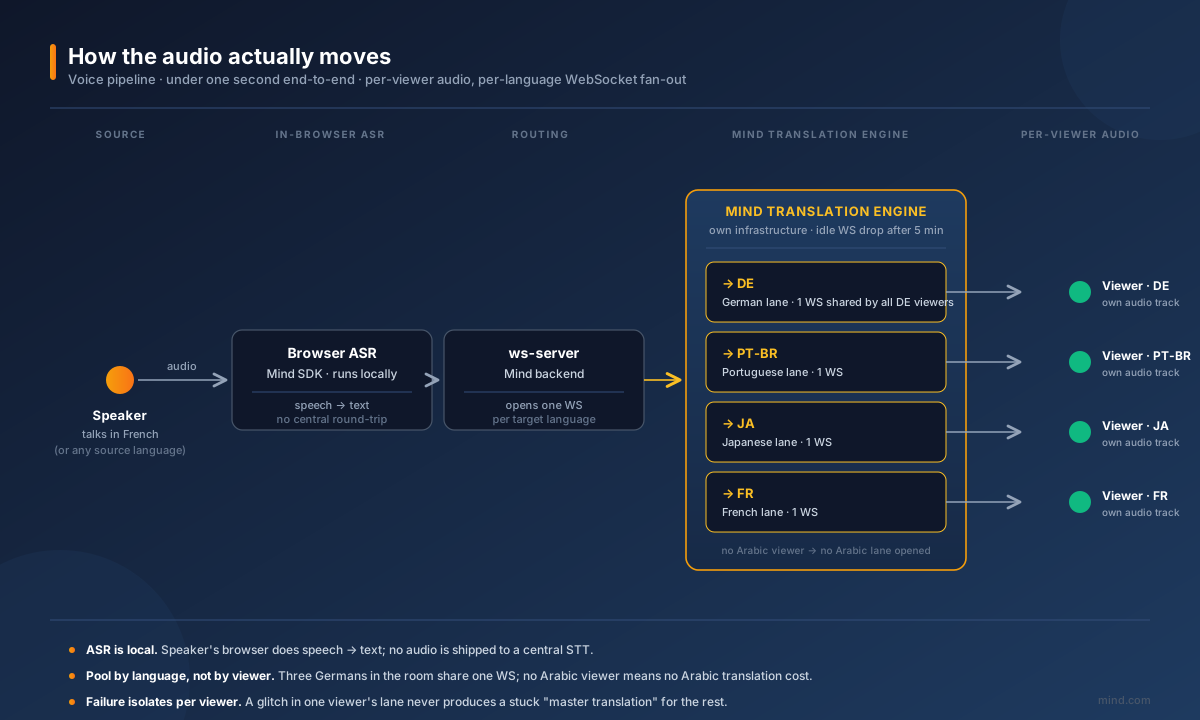
Как всъщност се движи аудиото

Пайплайн за превод на глас: браузърът на говорещия изпраща аудио през WebRTC към нашия собствен двигател — медиасървъра на Mind API в OVH, Франция — който разпознава речта (ASR) и превежда на всеки целеви език, присъстващ в стаята; всеки зрител получава собствена преведена аудиопътека, а ws-server получава думите от транскрипта за резюмето.

Няколко неща заслужават изрично споменаване:

  • ASR работи на медиасървъра. Аудиото на говорещия пътува през WebRTC към нашия собствен двигател — Mind API в OVH, Франция — и се разпознава там, на същия сървър, който пренася обаждането. Браузърът само изпраща аудио и получава думите обратно. Няма отделен доставчик на реч и няма допълнителен скок, преди преводът да може да започне. (Гласовите бележки в чата са изключение: речта в тях се превръща в текст чрез Azure AI Speech, речевата услуга на AI шлюза по подразбиране.)
  • Преводът не е един общ разклон. Двигателят превежда за всеки целеви език, присъстващ в стаята, а не за всеки зрител. Преводът на даден език започва, когато първият слушател на него поиска преведен поток. Трима участници, избрали немски, споделят един немски превод, а ако никой не слуша на арабски, нищо не се превежда на арабски. Затова среща на четири езика струва колкото среща на четиридесет езика, стига да се гледа кой реално е дошъл: никога не превеждаме на езици, на които никой участник не слуша.
  • Синтезираната реч е за всеки зрител поотделно. Всеки участник получава собствена преведена аудиопътека, смесена с видеото на оригиналния говорещ. Те не гледат общ „преведен срещата“, а гледат същата среща, като личният им аудиоканал е преведен на избрания от тях език. Затова двама души в една и съща физическа стая могат да сложат слушалки и да чуват различни езици.

Защо това е важно, когато срещата тръгне накриво

При 60-минутно обаждане с осем езика нещата се чупят по интересни начини: WebSocket връзки прекъсват, ASR временно разпознава грешно собствено име, мрежата на някой участник се разтреперва. Описаната архитектура ни позволява да изолираме отказите. Проблемът в аудиото на един зрител не засяга останалите седем, защото двигателят за превод никога не е произвеждал „превода“ — произвел е осем, паралелно, и само засегнатият трябва да се възстанови.

Самият двигател е наш и работи на собствена инфраструктура. Не пренасочваме гласа в реално време през външни LLM с общо предназначение. Бюджетът за забавяне ги изключва, а изискванията за резидентност на данните ги изключват за регулираните клиенти, на които това наистина им пука.

Какво публикуваме за качеството на гласа: /benchmark пуска производствения гласов пайплайн срещу изречения от FLORES-200 за всяка публикувана двойка езици, всеки месец. Оценяващият модел е посочен (Gemini 3.7 Flash основен, Claude Sonnet 5 резервен). Пълното разпределение — медиана, p10, p90, минимум, максимум, размер на извадката — е на страницата. Вижте методологията, за да разберете какво тези числа измерват и какво не.


Пайплайн 2: Превод на чат в реално време

Проблемът: Всяко съобщение в чата на срещата се превежда за всеки участник на неговия език, в момента на изпращането. Плюс редакциите, а те трябва да изглеждат като редакции, не като нови преводи.

Бюджетът: по-свободен от този за гласа. Съобщение в чата може да се появи на друг език с малко закъснение, без никой да му обръща внимание. Хората се интересуват дали преводът е верен и дали редакциите имат смисъл.

Какво всъщност прави пайплайнът за чат

Всяко съобщение минава през същия двигател за превод като гласовия пайплайн, но с различна предварителна и последваща обработка:

  • HTML структурата се запазва. Чатът поддържа форматиран текст (абзаци, списъци, цитати, получер, курсив). Преобразуваме го в обикновен текст за модела, превеждаме и след това обвиваме резултата обратно в оригиналните тагове. Моделът никога не вижда HTML, а чиста проза.
  • Цитатите се превеждат независимо. Ако отговорите на съобщение и го цитирате, блокът [QUOTE]…[/QUOTE] и новото съдържание се превеждат като отделни единици, така че моделът да не обърка двете.
  • Дългите съобщения се разделят на части. Режем по граници на абзаци при 1000 знака на част. Всяка част е отделно извикване за превод. Не подаваме на модела 4000-знакови „романи“ наведнъж: проблемите (отрязване, загубени абзаци, прекъснати по средата изречения) са прекалено грозни.
  • Преводът е мързелив (lazy). Използваме IntersectionObserver: съобщението се превежда само когато попадне в зоната на видимост на зрителя. Преди смяната на езика в дълго живеещ канал възпроизвеждаше всяко извикване на API за превод от историята. Сега вече не го прави.

Интересната част: редакции като разлики

във v1.2 променихме как се държат редакциите в чата за зрители на друг език. Старото поведение беше: някой редактира съобщение, превеждаме го наново изцяло, вие виждате нов абзац и трябва сами да откриете какво се е променило.

Новото поведение:

  1. Оригиналното съобщение вече е преведено на вашия език.
  2. Когато подателят редактира, превеждаме новата версия.
  3. Изчисляваме разликата между вашия предишен превод и вашия нов превод, на вашия език.
  4. Показваме тази разлика в самия текст — по същия начин, по който Git показва какво е променено.

Така когато „review by Tuesday“ стане „review by Thursday“ на английски, вашият испаноезичен колега вижда подчертано martes → jueves, а не пренаписан абзац, който трябва да прочете отново.

Това изискваше да третираме пайплайна за чат като запазващ състояние кеш за всеки зрител, а не като крайна точка за превод при заявка без състояние. Документите и гласът нямат нужда от това. Чатът има.


Пайплайн 3: Превод на споделени бележки в реално време

Проблемът: Домакинът отваря панела за споделени бележки и започва да пише. Всеки участник вижда бележките на своя език, символ по символ, със структурата на документа — заглавия, вложени списъци, чеклисти, кодови блокове — непокътната.

Бюджетът: Като при чата, но с две допълнителни ограничения:

  • Това, което се превежда, се променя по време на превода. Домакинът още пише. Наивна система, която превежда „целия документ“ при всяко натискане на клавиш, води до трептене и изразходва бюджета за API. Ние превеждаме на ниво променена единица, не на целия документ.
  • Структурата трябва да оцелее. Ако поискате от модел за превод да преведе markdown блок с три вложени списъка, ще получите нещо, което изглежда като оригинала, но с леко сплескана йерархия, преномерирани елементи или преместени отстъпи. Не позволяваме на модела да вижда целия блок.

Как пайплайнът за бележки се различава от чата

Основното е запазването на структурата. Превеждаме всеки елемент от списък независимо, а не като един документ. Моделът вижда:

„Compliance review — Q2 deliverables“

— а не:

"# Project plan\n## Quarter\n- Compliance review — Q2 deliverables\n- Vendor scoring\n - Tier 1 vendors..."

Обграждащият документ — <ul>, заглавията, отстъпите — се изгражда наново от страната на клиента със същата структура, която е имал оригиналният документ, като всеки листов възел се заменя със своя превод. Моделът никога не получава възможност да „подобрява“ йерархията.

Бележките използват и същия модел на разлики за всеки зрител като редакциите в чата: ако домакинът промени ред, зрителите на други езици виждат подчертани променените думи, а не нов абзац.


Пайплайн 4: Асинхронен превод на документи

Проблемът: Някой пуска в чата 40-странично PDF, Word документ, PowerPoint презентация или Excel таблица. Всеки участник може да поиска копие на собствения си език. Преведеният файл трябва да изглежда като оригинала — същите шрифтове, същите таблици, същите номера на страници, същите заглавни части, същите диаграми на мястото си.

Бюджетът: Няма ограничение в реално време. Една минута е наред. Две минути са наред. Ограничението е точността — ако преведеното PDF не прилича на оригинала, получателят няма да му се довери.

Защо този пайплайн не споделя двигател с гласа

Общ LLM, дори много добър, ще ви върне преведен текст на документа. Няма да ви върне преведено PDF със същото оформление. Моделът няма понятие за „прекъсване на страница, което трябва да съвпада с оригинала“ или „клетка на таблица, която трябва да запази ширината на колоната си“.

За тази повърхност използваме директно DeepL Document API. Той е създаден специално за превод на файлове като файлове, а не на проза, извлечена от файлове. DeepL работи с:

  • PDF (със запазване на оформлението)
  • DOCX, DOC
  • PPTX
  • XLSX

Документът се качва в пайплайна на DeepL, превежда се на сървъра със запазено форматиране и се връща в същия формат. След това качваме резултата в нашето обектно хранилище и го показваме обратно в чата като прикачен файл за изтегляне.

Какво струва това и защо не го крием

DeepL таксува минимум 50 000 знака на документ — приблизително един щатски долар на файл при плана Pro, независимо дали документът е една страница или тридесет. Поемаме тази цена, вместо да таксуваме на файл. Тя се появява в използването на превод на срещата като таксувани знаци, преобразувани в единици думи, които съответстват на начина, по който останалата част от продукта отчита активността по превод.

Избрахме DeepL за тази повърхност, защото преводът на файлове като файлове е точно задачата, за която е създаден, и не се опитахме да построим по-добър. Обратното не е вярно: DeepL няма гласов пайплайн на живо от вида, който построихме за срещите. Различни проблеми, различни инструменти. Честната версия на „какво задвижва превода в InterMIND“ е „правилният двигател за всеки пайплайн“, а не „нашият двигател, навсякъде“.

Езици, които този пайплайн покрива, а гласът не

Пайплайнът за документи достига 30 езика срещу 23 за гласа. Допълнителните включват: български, гръцки, естонски, индонезийски, литовски, латвийски, словашки, словенски. (Арабският също е в този списък и е един от допълнителните: той е изтеглен от избора на език в реално време, докато качеството на гласа му е под нашата летва, а оценките му по двойки остават публични на /benchmark — именно това число ще го върне. Асиметрията работи и в обратната посока при хинди — наличен за глас, но още не за файлове.)

Тази асиметрия е реална. Тя означава, че френскоговорящ участник в среща може да поиска PDF на договора на естонски, макар да не може да слуша срещата на естонски. Отбелязваме това в избора на език, вместо да го замазваме с едно число. Обосновката е в статията за броя езици.


Където пайплайните се срещат

Четирите пайплайна не работят изолирано. Стаята на срещата е мястото, където те се докосват, а шевовете имат значение:

  • Съобщение в чата с прикачен документ задейства пайплайна за чат за текста и пайплайна за документи за файла. Участникът на друг език вижда съобщението преведено веднага, а преводът на прикаченото идва асинхронно като файл за изтегляне.
  • Споделена бележка, която цитира ред от транскрипт, пресича бележки ↔ глас. Транскриптът е това, което гласовият пайплайн е произвел за езика на подателя, а преводът на бележката създава за всеки зрител копие на този цитат на езика на всички останали, със запазено посочване на източника.
  • Транскрипт, експортиран след срещата, пуска текстовия пайплайн в стила на чата върху целия разговор и произвежда файл за всеки език, който участниците могат да изтеглят. Това е същият път на кода като превода на чат, само че на партиди.

Изборът на език е една част от интерфейса. Инфраструктурата отдолу е четири пайплайна, които си говорят помежду си.


Какво умишлено не се опитваме да правим

  • Няма „единен модел за превод“. Не изграждаме един модел, който да прави глас, чат, бележки и документи. Компромисът между забавяне и точност няма победител. Използваме правилния двигател за всяка повърхност.
  • Няма тихо пренасочване. Ако пайплайнът за файлове днес не може да превежда на хинди, не се връщаме мълчаливо към гласовия двигател, преструвайки се, че е проработило — изборът на файл показва пропуска, вместо да го скрива.
  • Няма „превеждаме на 200 езика“. Нашият двигател излъчва 24. Живите повърхности предлагат 23, документите 30. Вместо едно маркетингово число, качеството по двойки, което трябва да издържи пред одитор, е публикувано на /benchmark, включително по-слабите двойки.

Опитайте сами

  • Пробвайте демото на живо — пуска гласовия пайплайн върху вашето аудио, на който и да е от 23-те езика на продукта. Същият пайплайн, който дава оценките на /benchmark.
  • Вижте бенчмарка — качество по двойки и по месеци върху реален трафик. Всяка двойка в избора на език, силна или слаба, с директна връзка.
  • Прочетете методологията — какво са числата, какво не са, кой е оценяващият.

Четири пайплайна, четири двигателя, една стая за срещи. Това е честната замяна на старата страница how-it-works.

— Екипът на Mind.com


Източници: DeepL — поддържани езици, DeepL — отчитане на използването и таксуване (минимумът от 50 000 знака на файл), FLORES-200; вътрешните факти за пайплайните са проверени спрямо внедрения код, към август 2026 г.

Английският е за първия контакт. Сделката се води на езика на партньора
Превод на живо

Английският е за първия контакт. Сделката се води на езика на партньора

Докъде стига английският в една експортна сделка, етап по етап: запитването, офертата, преговорите, рекламацията, следващата поръчка. Какво плаща днес експортният отдел за езика на партньора, с цени и източници, и какво остава със сделката след това.

The Mind.com Team

Гласов преводач за турски: глаголът идва накрая и това определя кой ви е необходим
Превод на живо

Гласов преводач за турски: глаголът идва накрая и това определя кой ви е необходим

В турския език глаголът, отрицанието и времето стоят в края на изречението. Този единствен факт разделя трите продукта, предлагани като „гласов преводач“: приложения за телефон, слушалки за превод и превод на живо по време на срещи. Какво може и какво не може всеки от тях да направи с турско изречение и защо броят езици, който посочва даден доставчик, не ви казва нищо за тази езикова двойка.

The Mind.com Team

Синхронен преводач: човек, RSI платформа или ИИ — какво е необходимо на вашата многоезична среща (2026)
Превод на живо

Синхронен преводач: човек, RSI платформа или ИИ — какво е необходимо на вашата многоезична среща (2026)

„Синхронен преводач“ е професия; това, което повечето търсения всъщност целят, е реч, която достига до слушателя на друг език, докато все още се изговаря. Това ръководство разграничава кабината, RSI платформата и синхронния превод с ИИ, сравнява инструментите според документацията им — Interprefy, KUDO, Wordly, DeepL Voice, Zoom, Teams, Google Meet, InterMIND — и задава въпроса, който сравненията пропускат: каква част от срещата всъщност се връща на вашия език и къде се обработват данните.

The Mind.com Team

Получавайте нови публикации и продуктови новини по имейл

Един имейл месечно с нови публикации и продуктови новини. Можете да се отпишете по всяко време.