داخل خطوط الترجمة الأربعة التي تشغّل InterMIND

لا توجد في InterMIND "ترجمة" واحدة. هناك أربعة خطوط — الصوت والدردشة والملاحظات والمستندات — لكل منها محرّكه الخاص وحدّ زمني للاستجابة ونطاق جودة خاص به. هذا ما يحدث فعلاً بين اللحظة التي تتحدث فيها واللحظة التي يفهمك فيها مشارك يتحدث لغة أخرى.

The Mind.com Team

  • أربعة خطوط، لا محرّك واحد. الصوت والدردشة والملاحظات والمستندات، لكلٍّ منها محرّكه وميزانية زمن الاستجابة ونطاق الجودة الخاص به، ولا يجمع بينها سوى أداة اختيار اللغة.
  • مهام مختلفة، محرّكات مختلفة. يعمل الصوت لكل لغة مستهدفة موجودة في الغرفة على محرّكنا الخاص في فرنسا، بينما تذهب المستندات إلى Document API من DeepL: 23 لغة و30 لغة.
  • تُبقي InterMIND الاجتماع كله بلغة كل عضو: الصوت والدردشة والملاحظات والملفات، مع نشر جودة كل زوج لغوي شهريًا. ينضم الضيوف مجانًا عبر رابط ودون حساب، ولا تدفع إلا عن الأعضاء النشطين.
داخل خطوط الترجمة الأربعة التي تشغّل InterMIND

نظرة من الداخل على خطوط الترجمة الأربعة التي تشغّل InterMIND

صفحة /product/overview/how-it-works القديمة على mind.com متأخرة عن الواقع بعدة إصدارات رئيسية. فهي تصف «محرّك ترجمة» واحدًا على طريقة معظم صفحات الموردين: سهم كبير واحد من «أنت تتحدث» إلى «هم يسمعون». كانت تلك الصورة تبسيطًا قبل عامين، أما اليوم فهي خاطئة.

الحقيقة أن InterMIND تشغّل أربعة خطوط ترجمة منفصلة، يحلّ كلٌّ منها مشكلة مختلفة بمحرّك مختلف وميزانية زمن استجابة مختلفة ونطاق جودة مختلف. تشترك في أداة اختيار اللغة، لكنها لا تشترك في محرّك.

هذه هي الإجابة المحدّثة عن سؤال «كيف يعمل؟».

مقال مرافق: «كم لغة تدعمون؟» يشرح ما تغطيه كل منظومة (23 / 23 / 30 / 17). أما هذا المقال فيشرح ما يفعله كل خط، ولماذا هو كيان قائم بذاته.


لماذا «محرّك واحد لكل شيء» أكذوبة

على منصة الاجتماعات المباشرة أن تؤدي أربع مهام على الأقل في وقت واحد، وهي تتجاذب في اتجاهات متنافرة:

  1. الصوت في الوقت الفعلي: صوت يدخل وصوت مترجم يخرج والمتحدث لا يزال يتكلم، وكل مشاهد بلغته. القيد الصارم هو زمن الاستجابة.
  2. نص الدردشة في الوقت الفعلي: رسائل قصيرة وسريعة، مع الحفاظ على التعديلات والاقتباسات وبنية HTML.
  3. الملاحظات المشتركة في الوقت الفعلي: كتابة تعاونية حرفًا بحرف، مع بنية هرمية (قوائم وعناوين ومربعات اختيار) يجب أن تصمد أمام الترجمة.
  4. ملفات المستندات غير المتزامنة: ملف PDF من 40 صفحة يُلقى في الدردشة. لا ميزانية لزمن الاستجابة. القيد الصارم هو الأمانة للأصل: التنسيق والجداول وأرقام الصفحات والخطوط.

يمكنك بناء استدعاء LLM ضخم واحد يحاول أداء المهام الأربع. جرّبنا ذلك، وكان سيئًا في الأربع جميعًا. ميزانية زمن الاستجابة للصوت تعني أن النموذج لا يستطيع «التفكير»، وميزانية الأمانة للمستندات تعني أن عليه أن يفكّر. تعديل رسالة في الدردشة يحتاج إلى فروقات (diff) بلغة المشاهد، وملف PDF من 40 صفحة يحتاج إلى حفظ التنسيق، وهذا ما لا يقدّمه أي نموذج يبثّ الرموز تباعًا.

لذلك نشغّل أربعة. وهذا كل واحد منها.


الخط 1: ترجمة الصوت في الوقت الفعلي

المشكلة: يتحدث أحد المشاركين بالفرنسية. وينضم آخر بالألمانية، وثالث بالبرتغالية البرازيلية، ورابع باليابانية. يحتاج كل منهم إلى سماع المتحدث بلغته، في أذنه، بتأخير قصير بما يكفي ليظل التواصل البصري ممكنًا.

الميزانية: ألا ينتظر المستمع أبدًا. فحين تتأخر الترجمة المنطوقة إلى حدّ أن يبدأ الناس بالتحدث فوقها، ينجرف الاجتماع نحو «لنتحوّل إلى الإنجليزية فحسب».

كيف ينتقل الصوت فعليًا

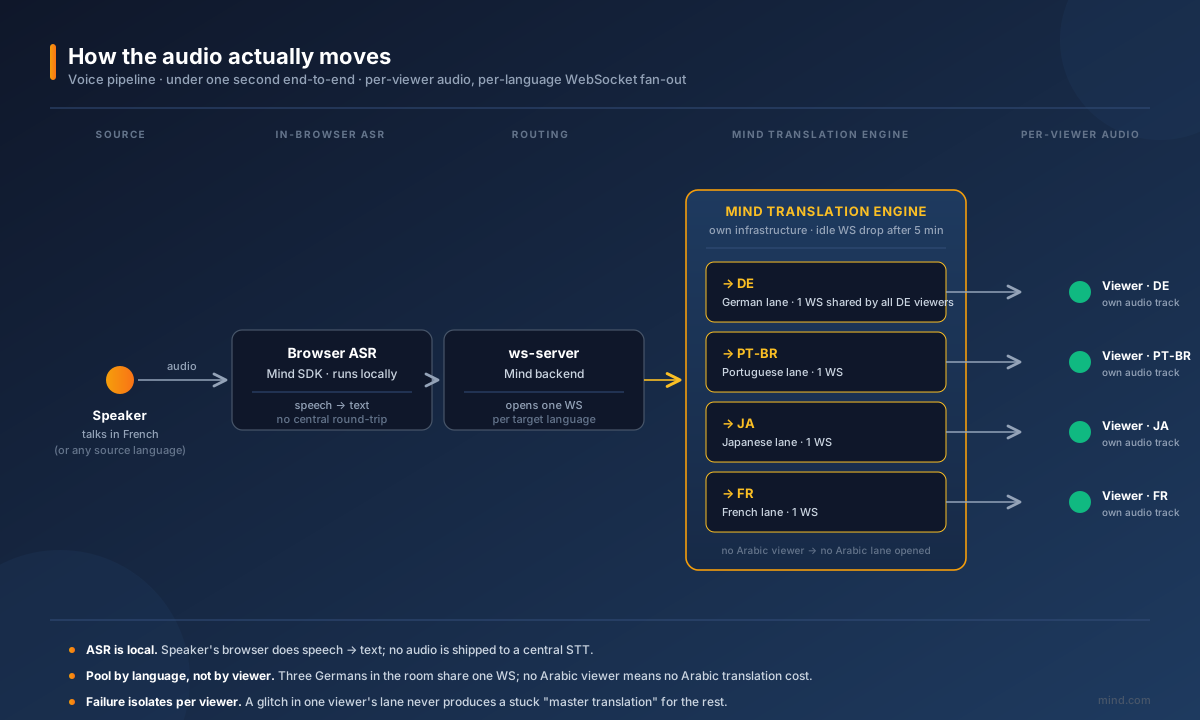
خط ترجمة الصوت: يرسل متصفح المتحدث الصوت عبر WebRTC إلى محرّكنا الخاص — خادم الوسائط Mind API لدى OVH في فرنسا — الذي يجري التعرّف على الكلام (ASR) ويترجم إلى كل لغة مستهدفة موجودة في الغرفة؛ يتلقى كل مشاهد مسار الصوت المترجم الخاص به، ويتلقى ws-server كلمات النص المفرَّغ من أجل الملخص.

بعض النقاط التي تستحق التسمية صراحةً:

  • التعرّف على الكلام (ASR) يعمل على خادم الوسائط. ينتقل صوت المتحدث عبر WebRTC إلى محرّكنا الخاص — Mind API لدى OVH في فرنسا — ويجري التعرّف عليه هناك، على الخادم نفسه الذي يحمل المكالمة؛ فالمتصفح يرسل الصوت فقط ويستقبل الكلمات. لا مزوّد كلام منفصل ولا قفزة إضافية قبل أن تبدأ الترجمة. (الاستثناء هو الرسائل الصوتية في الدردشة: يجري تحويل الكلام إلى نص فيها على Azure AI Speech، خدمة الكلام في بوابة الذكاء الاصطناعي الافتراضية.)
  • الترجمة ليست توزيعًا واحدًا إلى الجميع. يترجم المحرّك لكل لغة مستهدفة موجودة في الغرفة، لا لكل مشاهد: تبدأ الترجمة إلى لغة ما حين يطلب أول مستمع بها بثًا مترجمًا، ويتشارك ثلاثة مشاركين اختاروا الألمانية ترجمة ألمانية واحدة، وإذا لم يكن أحد يستمع بالعربية فلا شيء يُترجم إلى العربية. لهذا فإن اجتماعًا بأربع لغات يكلّف مثل اجتماع بأربعين لغة، بحسب من حضر فعلًا فقط: لا نترجم أبدًا إلى لغات لا يستمع بها أحد من المشاركين.
  • الكلام المصطنع يكون لكل مشاهد. يتلقى كل مشارك مسار صوت مترجمًا خاصًا به، مدمجًا مع فيديو المتحدث الأصلي. هم لا يشاهدون «اجتماعًا مترجمًا» رئيسيًا، بل يشاهدون الاجتماع نفسه بقناة صوت شخصية مترجمة إلى لغتهم المختارة. لهذا يستطيع شخصان في الغرفة الفعلية نفسها أن يضع كلٌّ منهما سماعات ويسمع لغة مختلفة.

لماذا يهم هذا حين يسير الاجتماع في الاتجاه الخاطئ

في مكالمة مدتها 60 دقيقة بثماني لغات، تتعطل الأشياء بطرق مثيرة: تنقطع WebSockets، ويخطئ ASR مؤقتًا في كتابة اسم علم، وتصبح شبكة أحد المشاركين متقطعة. البنية أعلاه هي ما يتيح لنا عزل الأعطال: تشوّش الصوت عند مشاهد واحد لا يؤثر في السبعة الآخرين، لأن محرّك الترجمة لم ينتج «الترجمة» أصلًا، بل أنتج ثماني ترجمات بالتوازي، ولا يحتاج إلى التعافي إلا الخط المتأثر.

المحرّك نفسه ملكنا، ويعمل على بنيتنا التحتية الخاصة. لا نمرّر الصوت في الوقت الفعلي عبر نماذج LLM عامة الغرض تابعة لجهات خارجية. ميزانية زمن الاستجابة تستبعدها، وملف إقامة البيانات يستبعدها لدى العملاء الخاضعين للتنظيم، وهم من يهتم بذلك فعلًا.

ما ننشره عن جودة الصوت: تشغّل /benchmark خط الصوت الإنتاجي على جمل FLORES-200 لكل زوج لغوي منشور، شهريًا. الحَكَم مُسمّى (Gemini 3.7 Flash أساسي وClaude Sonnet 5 احتياطي). والتوزيع الكامل — الوسيط وp10 وp90 والحد الأدنى والحد الأقصى وحجم العيّنة — موجود على الصفحة. راجع المنهجية لمعرفة ما تقيسه هذه الأرقام وما لا تقيسه.


الخط 2: ترجمة الدردشة في الوقت الفعلي

المشكلة: كل رسالة دردشة في الاجتماع تُترجم لكل مشارك بلغته، لحظة إرسالها. إضافة إلى التعديلات، والتعديلات يجب أن تبدو كتعديلات لا كإعادة ترجمة.

الميزانية: أرحب من الصوت. يمكن لرسالة الدردشة أن تتأخر لحظة قبل ظهورها بلغة أخرى دون أن يهتم أحد. ما يهم الناس هو أن تكون الترجمة صحيحة وأن تكون التعديلات مفهومة.

ما الذي يفعله خط الدردشة فعليًا

تمرّ كل رسالة عبر محرّك الترجمة نفسه الذي يستخدمه خط الصوت، لكن بمعالجة مسبقة ولاحقة مختلفة:

  • بنية HTML محفوظة. تدعم الدردشة النص المنسّق (فقرات وقوائم واقتباسات وخط عريض ومائل). نحوّله إلى نص عادي من أجل النموذج، ونترجم، ثم نعيد لفّ النتيجة بالوسوم الأصلية. لا يرى النموذج HTML أبدًا، بل يرى نثرًا نظيفًا.
  • الاقتباسات تُترجم بشكل مستقل. إذا رددت على رسالة واقتبستها، فإن الكتلة [QUOTE]…[/QUOTE] والمحتوى الجديد يُترجمان كوحدتين منفصلتين، حتى لا يخلط النموذج بينهما.
  • الرسائل الطويلة تُقسَّم. نقسّم عند حدود الفقرات بمعدل 1,000 حرف للقطعة. كل قطعة هي استدعاء ترجمة مستقل. لا نغذّي النموذج بـ«روايات» من 4,000 حرف دفعة واحدة، فأنماط الفشل (البتر وضياع الفقرات وانقطاع الجمل في منتصفها) قبيحة جدًا.
  • الترجمة كسولة. نستخدم IntersectionObserver: لا تُترجم الرسالة إلا حين تظهر في نافذة عرض المشاهد. كان تبديل اللغات في قناة طويلة العمر يعيد تشغيل كل استدعاءات واجهة الترجمة من السجل. الآن لم يعد ذلك يحدث.

الجزء المثير: التعديلات كفروقات (diffs)

في الإصدار v1.2 غيّرنا سلوك تعديلات الدردشة للمشاهدين بلغة أخرى. كان السلوك القديم: يعدّل شخص رسالة، فنعيد ترجمتها كاملة، فترى فقرة جديدة وعليك أن تكتشف ما الذي تغيّر.

السلوك الجديد:

  1. كانت الرسالة الأصلية قد تُرجمت مسبقًا إلى لغتك.
  2. حين يعدّل المرسل، نعيد ترجمة النسخة الجديدة.
  3. نحسب الفرق بين ترجمتك السابقة وترجمتك الجديدة، بلغتك.
  4. نعرض هذا الفرق ضمن النص، بالطريقة نفسها التي يريك بها Git ما تغيّر.

فحين تتحول «review by Tuesday» إلى «review by Thursday» بالإنجليزية، يرى زميلك الذي يقرأ بالإسبانية martes → jueves مظلّلة، لا فقرة معاد ترجمتها يضطر إلى إعادة قراءتها.

تطلّب هذا التعامل مع خط الدردشة بوصفه ذاكرة تخزين مؤقت ذات حالة لكل مشاهد، لا نقطة نهاية عديمة الحالة تترجم عند الطلب. المستندات والصوت لا تحتاجان إلى هذا. أما الدردشة فتحتاجه.


الخط 3: ترجمة الملاحظات المشتركة في الوقت الفعلي

المشكلة: يفتح المضيف لوحة ملاحظات مشتركة ويبدأ الكتابة. يرى كل مشارك الملاحظات بلغته، حرفًا بحرف، مع بقاء بنية المستند — العناوين والقوائم المتداخلة وقوائم المهام وكتل الشيفرة — سليمة.

الميزانية: مثل الدردشة، مع قيدين إضافيين:

  • الشيء المُترجَم يتغيّر أثناء الترجمة. المضيف لا يزال يكتب. النظام الساذج الذي يترجم «المستند كله» مع كل ضغطة مفتاح يُنتج وميضًا ويستنزف ميزانية الواجهة. نحن نترجم بحبيبية الوحدة التي تغيّرت، لا المستند كله.
  • يجب أن تصمد البنية. إذا طلبت من نموذج ترجمة أن يترجم كتلة markdown فيها ثلاث قوائم متداخلة، فستحصل على شيء يبدو كالأصل لكن بهرمية مسطّحة قليلًا، أو بنود أُعيد ترقيمها، أو مسافات بادئة تغيّر موضعها. لا ندع النموذج يرى الكتلة كاملة.

كيف يختلف خط الملاحظات عن الدردشة

الحفاظ على البنية هو الأساس. نترجم كل بند في القائمة بشكل مستقل بدلًا من ترجمة مستند واحد. يرى النموذج:

"Compliance review — Q2 deliverables"

لا هذا:

"# Project plan\n## Quarter\n- Compliance review — Q2 deliverables\n- Vendor scoring\n - Tier 1 vendors..."

أما المستند المحيط — وسم <ul> والعناوين والمسافات البادئة — فيُعاد بناؤه من جهة العميل بالبنية نفسها التي كانت للمستند الأصلي، مع استبدال كل عقدة ورقية بترجمتها. لا يُسمح للنموذج أبدًا بـ«تحسين» الهرمية.

وتستخدم الملاحظات أيضًا نموذج الفروقات لكل مشاهد نفسه المستخدم في تعديلات الدردشة: إذا غيّر المضيف سطرًا، يرى المشاهدون بلغات أخرى الكلمات المتغيّرة مظلّلة، لا فقرة جديدة.


الخط 4: ترجمة المستندات غير المتزامنة

المشكلة: يُلقي أحدهم في الدردشة ملف PDF من 40 صفحة، أو مستند Word، أو عرض PowerPoint، أو جدول Excel. يستطيع كل مشارك طلب نسخة بلغته. ويجب أن يبدو الملف المترجم كالأصل: الخطوط نفسها والجداول نفسها وأرقام الصفحات نفسها والترويسات نفسها والرسوم البيانية في مواضعها.

الميزانية: لا قيد في الوقت الفعلي. دقيقة واحدة مقبولة. ودقيقتان مقبولتان. القيد هو الأمانة للأصل: إذا لم يبدُ ملف PDF المترجم كالأصل، فلن يثق به المتلقي.

لماذا لا يتشارك هذا الخط محرّكًا مع الصوت

نموذج عام، حتى لو كان جيدًا جدًا، سيعيد إليك نصًا مترجمًا من المستند. لن يعيد إليك ملف PDF مترجمًا بالتخطيط نفسه. ليس لدى النموذج مفهوم «فاصل صفحة يجب أن يتطابق مع المصدر» أو «خلية جدول يجب أن تحتفظ بعرض عمودها».

لهذه الواجهة نستخدم DeepL Document API مباشرةً. إنها مصمّمة لترجمة الملفات بوصفها ملفات، لا نثرًا مستخرجًا من ملفات. ويتعامل DeepL مع:

  • PDF (مع الحفاظ على التخطيط)
  • DOCX وDOC
  • PPTX
  • XLSX

يُرفع المستند إلى خط DeepL، ويُترجم على الخادم مع بقاء التنسيق كما هو، ويُعاد بالصيغة نفسها. ثم نرفع النتيجة إلى مخزن الكائنات لدينا ونعرضها في الدردشة مرفقًا قابلًا للتنزيل.

ما تكلفة هذا ولماذا لا نخفيها

يحتسب DeepL حدًا أدنى قدره 50,000 حرف لكل مستند — نحو دولار أمريكي واحد للملف في خطة Pro، سواء كان المستند صفحة واحدة أو ثلاثين. نتحمّل هذه التكلفة بدلًا من تحميلها على الملف؛ وتظهر في استخدام الترجمة للاجتماع بوصفها أحرفًا مفوترة، محوّلة إلى وحدات كلمات تتوافق مع الطريقة التي يبلّغ بها بقية المنتج عن نشاط الترجمة.

اخترنا DeepL لهذه الواجهة لأن ترجمة الملفات بوصفها ملفات هي بالضبط المهمة التي بُني من أجلها، ولم نحاول بناء ما هو أفضل منه. والعكس ليس صحيحًا: DeepL لا يشغّل خط صوت مباشر من النوع الذي بنيناه للاجتماعات. مشكلات مختلفة، أدوات مختلفة. النسخة الصادقة من «ما الذي يشغّل ترجمة InterMIND» هي «المحرّك المناسب لكل خط»، لا «محرّكنا في كل مكان».

اللغات التي يغطيها هذا الخط ولا يغطيها الصوت

يصل خط المستندات إلى 30 لغة، مقابل 23 للصوت. وتشمل الإضافات: البلغارية واليونانية والإستونية والإندونيسية واللتوانية واللاتفية والسلوفاكية والسلوفينية. (العربية أيضًا في هذه القائمة، وهي من الإضافات: فهي مسحوبة من أداة الاختيار في الوقت الفعلي ما دامت جودة صوتها دون المستوى الذي نطلبه، وتبقى درجات أزواجها اللغوية علنية على /benchmark، وذلك الرقم هو ما سيعيدها. أما التفاوت فيسير في الاتجاه المعاكس بالنسبة إلى الهندية: متاحة للصوت، وغير متاحة بعد للملفات.)

هذا التفاوت حقيقي. فهو يعني أن مشاركًا فرنسيًا في اجتماع يستطيع طلب ملف PDF للعقد بالإستونية رغم أنه لا يستطيع الاستماع إلى الاجتماع بالإستونية. نشير إلى ذلك في أداة الاختيار بدلًا من تلطيفه برقم واحد. والمبررات في مقال عدد اللغات.


حيث تلتقي الخطوط

لا تعمل الخطوط الأربعة بمعزل عن بعضها. غرفة الاجتماع هي المكان الذي تتلامس فيه، والمواضع التي تلتقي عندها مهمة:

  • رسالة دردشة مرفق بها مستند تُشغّل خط الدردشة للنص وخط المستندات للملف. يرى المشارك بلغة أخرى الرسالة مترجمة فورًا، ويصله ترجمة المرفق بشكل غير متزامن ملفًا قابلًا للتنزيل.
  • ملاحظة مشتركة تقتبس سطرًا من النص المفرَّغ تعبر بين الملاحظات ↔ الصوت. النص المفرَّغ هو ما أنتجه خط الصوت بلغة المرسل؛ وترجمة الملاحظة تنتج نسخة لكل مشاهد من ذلك الاقتباس بلغات الآخرين، مع الحفاظ على نسبته إلى مصدره.
  • نص مفرَّغ يُصدَّر بعد الاجتماع يمرّر خط النص على نمط الدردشة على المحادثة بأكملها، فيُنتج ملفًا لكل لغة يستطيع المشاركون تنزيله. إنه مسار الشيفرة نفسه المستخدم في ترجمة الدردشة، لكن على دفعات.

أداة اختيار اللغة قطعة واحدة من الواجهة. أما البنية التحتية تحتها فأربعة خطوط تتحدث إلى بعضها.


ما لا نحاوله عمدًا

  • لا «نموذج ترجمة موحّد». لا نبني نموذجًا واحدًا يؤدي الصوت والدردشة والملاحظات والمستندات. المفاضلة بين زمن الاستجابة والأمانة للأصل لا فائز فيها. نستخدم المحرّك المناسب لكل واجهة.
  • لا إعادة توجيه صامتة. إذا كان خط الملفات لا يستطيع الترجمة إلى الهندية اليوم، فلن نعود بهدوء إلى محرّك الصوت ونتظاهر بأن الأمر نجح؛ فأداة اختيار الملفات تشير إلى الفجوة بدلًا من إخفائها.
  • لا «نترجم إلى 200 لغة». محرّكنا يُخرج 24. والواجهات المباشرة تقدّم 23، والمستندات 30. وبدلًا من رقم واحد مناسب للتسويق، تُنشر جودة كل زوج لغوي، وهي التي يجب أن تصمد أمام المدقّق، على /benchmark، بما في ذلك الأزواج الأضعف.

جرّبها بنفسك

أربعة خطوط، أربعة محرّكات، غرفة اجتماع واحدة. هذا هو البديل الصادق عن صفحة how-it-works القديمة.

— فريق Mind.com


المصادر: DeepL — اللغات المدعومة، DeepL — احتساب الاستخدام والفوترة (الحد الأدنى 50,000 حرف لكل ملف)، FLORES-200؛ وقائع الخطوط الداخلية جرى التحقق منها مقابل الشيفرة المشحونة، وجرى التحقق في أغسطس 2026.

المزيد في الترجمة الفورية

جميع المقالات في الترجمة الفورية
الإنجليزية تفتح باب التواصل الأول، أما الصفقة فتُدار بلغة الشريك
الترجمة الفورية

الإنجليزية تفتح باب التواصل الأول، أما الصفقة فتُدار بلغة الشريك

أين تتوقف الإنجليزية في صفقة التصدير، مرحلةً بمرحلة: الاستفسار، وعرض السعر، والتفاوض، والمطالبة، والطلب التالي. وكم يدفع قسم التصدير اليوم مقابل التواصل بلغة الشريك، مع الأسعار والمصادر، وما الذي يبقى مع الصفقة بعد ذلك.

The Mind.com Team

مترجم صوتي للتركية: الفعل يأتي في النهاية، وهذا ما يحدد أيّ مترجم تحتاج
الترجمة الفورية

مترجم صوتي للتركية: الفعل يأتي في النهاية، وهذا ما يحدد أيّ مترجم تحتاج

في التركية يأتي الفعل، وكذلك النفي والزمن، في نهاية الجملة. هذه الحقيقة الواحدة هي ما يفرّق بين المنتجات الثلاثة التي تُباع باسم «مترجم صوتي»: تطبيقات الهاتف، وسماعات الترجمة، والترجمة الحية في الاجتماعات. نوضح ما يستطيع كل منها وما لا يستطيع فعله مع جملة تركية، ولماذا لا يخبرك عدد اللغات الذي يعلنه المزوّد بشيء عن هذا الزوج اللغوي.

The Mind.com Team

المترجم الفوري: بشري أم منصة RSI أم الذكاء الاصطناعي — ما الذي يحتاجه اجتماعك متعدد اللغات (2026)
الترجمة الفورية

المترجم الفوري: بشري أم منصة RSI أم الذكاء الاصطناعي — ما الذي يحتاجه اجتماعك متعدد اللغات (2026)

«المترجم الفوري» مهنة؛ أما ما يبحث عنه معظم الناس فعلًا فهو وصول الكلام بلغة أخرى أثناء النطق به. يفصل هذا الدليل بين الكابينة ومنصة RSI والترجمة الفورية بالذكاء الاصطناعي، ويقارن الأدوات استنادًا إلى وثائقها — Interprefy وKUDO وWordly وDeepL Voice وZoom وTeams وGoogle Meet وInterMIND — ويطرح ما تتجاهله المقارنات: كم من الاجتماع يعود فعلًا بلغتك، وأين تُعالَج البيانات.

The Mind.com Team

احصل على المنشورات الجديدة وتحديثات المنتج عبر البريد الإلكتروني

رسالة بريدية واحدة شهريًا مع منشورات جديدة وتحديثات المنتج. ألغِ الاشتراك في أي وقت.